正規分布を足す?
 マナブ先生
前回は、一つの正規分布について学びましたね。
平均値 \(\mu\) が分布の中心を決め、
標準偏差 \(\sigma\) がばらつきの大きさを決める、という話でした。
 ユキさん
はい。
そして標準化すると、
\[
z=\frac{x-\mu}{\sigma}
\]
となって、平均0、標準偏差1の標準正規分布に変換できるんでしたね。
マナブ先生そうですね。
では今日は少し違うことを考えてみましょう。
二つの正規分布を足したり引いたりしたら、どうなるでしょう?
 ユキさん
正規分布を足すんですか?
曲線そのものを足すということでしょうか。
マナブ先生いい疑問ですね。
曲線そのものを足すのではありません。
例えば、二つの異なる集団からそれぞれ一つずつ値を取り出して、
その値同士を足したり、引いたりする
という意味です。
具体的な例で考えてみましょう。
2校の数学の成績を比べてみる
マナブ先生全国規模の大学入試模擬試験があったとします。
その中に、
全国でも有名な進学校のA校
と、
標準的な高校のB校
があったとしましょう。
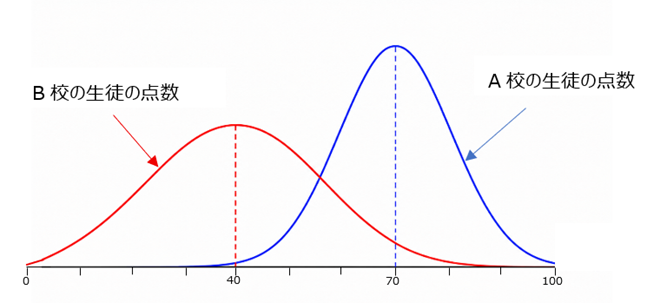
数学の成績について、A校では、
\[
\text{平均}=70点
\]
\[
\text{標準偏差}=10点
\]
だったとします。
一方、B校では、
\[
\text{平均}=40点
\]
\[
\text{標準偏差}=15点
\]
だったとします。
 ユキさん
A校の方が平均点は30点高いですね。
ただ、B校の方が標準偏差が大きいので、
点数のばらつきも大きいということですね。
マナブ先生その通りです。
それぞれの点数が、おおよそ正規分布に従うとすると、
イメージとしてはこんな感じです。
 マナブ先生
A校の点数を \(X\)、B校の点数を \(Y\) とすると、
\[
X\sim N(70,10^2)
\]
\[
Y\sim N(40,15^2)
\]
と表すことができます。
ユキさんA校は平均70、分散100。
B校は平均40、分散225という意味ですね。
マナブ先生そうです。
ではここからが今日のテーマです。
「A校の生徒-B校の生徒」を繰り返したら?
マナブ先生A校から生徒を一人選び、その数学の点数を \(X\) とします。
同じようにB校から一人選び、その点数を \(Y\) とします。
そして、
\[
D=X-Y
\]
つまり、
「A校の生徒の点数-B校の生徒の点数」
を計算するとしましょう。
これをたくさんの組み合わせについて繰り返します。
ユキさんなるほど。
例えばA校の生徒が75点で、B校の生徒が45点なら、
$$ 75-45=30 $$
ですね。
マナブ先生そうです。
別の組み合わせなら、
A校が60点、B校が55点で、
$$ 60-55=5 $$
かもしれません。
あるいは、
A校が85点、B校が30点なら、
$$ 85-30=55 $$
です。
ユキさん差も毎回変わるんですね。
マナブ先生そこが重要です。
つまり、
\[
D=X-Y
\]
も、一つのばらつきを持つデータになるわけです。
では、その差 \(D\) の平均は、どのくらいになると思いますか?
ユキさんA校の平均が70点、B校の平均が40点ですから、
$$ 70-40=30 $$
で、平均すると30点くらいになりそうです。
マナブ先生その通りです。
したがって、
\[
\mu_X-\mu_Y
=70-40
=30
\]
です。
では「差のばらつき」はどうなる?
マナブ先生では問題はここからです。
この点数差 \(D\) の標準偏差はどうなるでしょう?
ユキさんA校が10点、B校が15点ですから……
$$ 10-15=-5 $$
……というわけにはいきませんね。
標準偏差がマイナスになるのはおかしいです。
マナブ先生そうですね。
では逆に、
$$ 15-10=5 $$
でしょうか?
ユキさんそれも変な気がします。
どちらからどちらを引くかで標準偏差が変わってしまいます。
マナブ先生いいところに気づきました。
では、少し数式から離れて考えてみましょう。
もしA校の点数が毎回70点でまったくばらつかず、
B校も毎回40点だったら、点数差は?
ユキさんいつも30点です。
差のばらつきはゼロですね。
マナブ先生ではA校の点数だけが70点の周辺でばらついたら?
ユキさん差もばらつきます。
マナブ先生さらにB校の点数もばらついたら?
ユキさん……差はもっといろいろな値になりそうですね。
マナブ先生そうでしょう。
つまり、
二つの値を引き算するからといって、
「ばらつきまで小さくなるとは限らない」
のです。
ユキさんむしろ、A校にもB校にもばらつきがあるので、
その両方が差のばらつきに効いてくるんですね。
 マナブ先生
まさにそこです。
標準偏差ではなく「分散」を使う
マナブ先生ここで、標準偏差そのものではなく、
標準偏差を二乗した分散を使います。
A校の分散は、
\[
10^2=100
\]
B校の分散は、
\[
15^2=225
\]
ですね。
ユキさんはい。
マナブ先生A校とB校から選ばれる生徒の点数が互いに独立だとすると、
差 \(D=X-Y\) の分散は、
\[
{\sigma_X}^2+{\sigma_Y}^2
\]
となります。
ユキさんちょっと待ってください。
引き算なのに、
分散は足し算
なんですか?
マナブ先生そうです。
ここは、とても大切なところです。
「引き算なのに分散は足す」を直感で考える
マナブ先生例えば、
\[
D=X-Y
\]
について考えてみましょう。
A校の \(X\) が平均より大きくなったら、
\(D\) はどうなりますか?
ユキさん大きくなります。
マナブ先生ではB校の \(Y\) が平均より大きくなったら?
ユキさん\(Y\) を引いているので、\(D\) は小さくなります。
マナブ先生そうですね。
しかし、どちらの場合も、
30点という平均的な差から離れる原因
になりますよね。
ユキさんあっ、なるほど。
A校側のばらつきも、B校側のばらつきも、
どちらも「差のばらつき」を増やす方向に働くんですね。
マナブ先生その通りです。
だから、値そのものは引き算していても、
独立な二つのばらつきの大きさは足し合わされる
のです。
実際に計算してみよう
マナブ先生では、ユキさんに計算してもらいましょう。
差の分散は、
\[
10^2+15^2
\]
です。
ユキさん\[
100+225=325
\]
ですね。
マナブ先生では標準偏差は?
ユキさん分散の平方根なので、
\[
\sqrt{325}
\approx18.03
\]
です。
約18点ですね。
マナブ先生そうです。
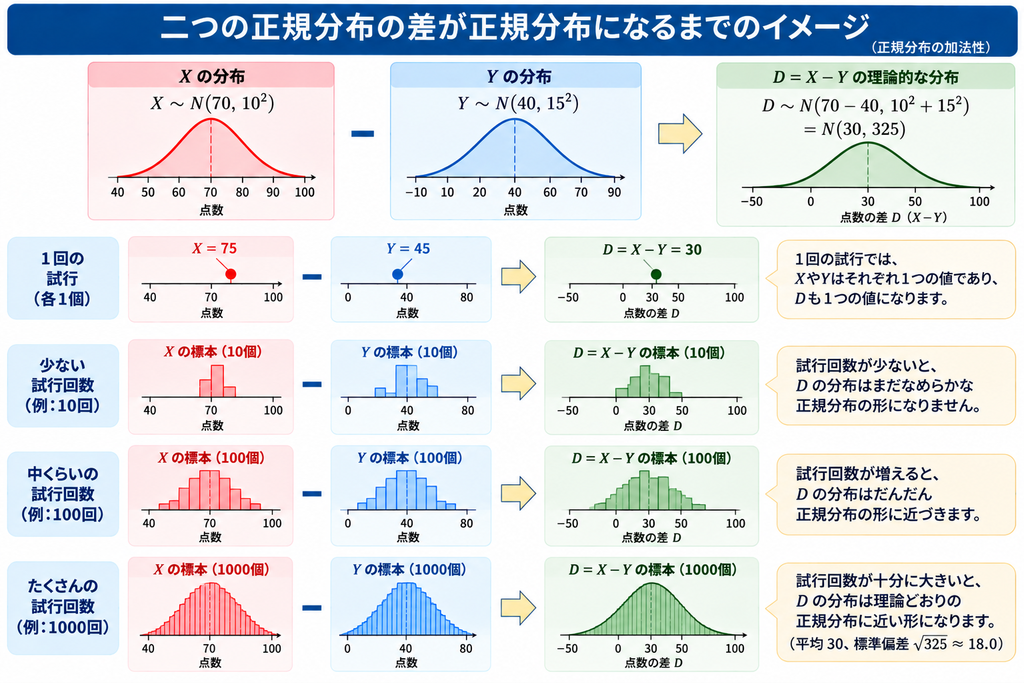
したがって、A校の生徒の点数からB校の生徒の点数を引いた値 \(D\) は、
\[
D=X-Y
\]
として、
\[
D\sim N(30,325)
\]
つまり、
\[
D\sim N(30,18.03^2)
\]
という正規分布になります。
ユキさん差の平均は30点で、
その差自体にも標準偏差約18点のばらつきがある、
ということなんですね。
マナブ先生その通りです。
ユキさん整理すると、
A校からB校を引いたとき、
平均値は、
\[
70-40=30
\]
ですが、
分散は、
\[
10^2+15^2=325
\]
になる。
マナブ先生そうです。
ここは言葉で覚えると分かりやすいでしょう。
「平均は引く。でも独立なばらつきは足す。」
ユキさんこれは覚えやすいですね。
マナブ先生では今度は、
\[
S=X+Y
\]
を考えてみましょう。
例えばA校とB校の生徒一人ずつの点数を足した値です。
平均値はどうなりますか?
ユキさん今度は普通に、
\[
70+40=110
\]
ですね。
マナブ先生そうです。
では分散は?
ユキさん引き算でも足したのだから、今度も、
\[
10^2+15^2=325
\]
ですね。
マナブ先生その通りです。
したがって、
\[
X+Y
\sim
N(110,325)
\]
となります。
ユキさんつまり足し算の場合も引き算の場合も、
分散は同じように足す
んですね。
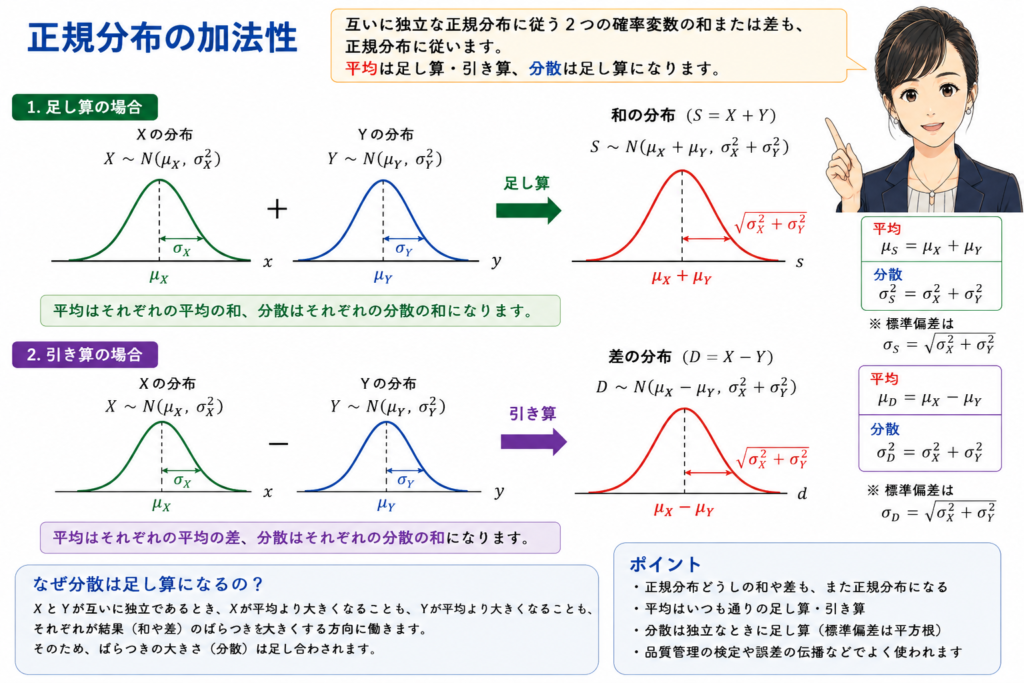
正規分布の加法性
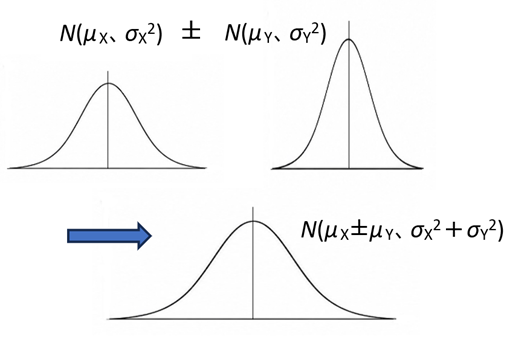
マナブ先生ここまでを一般的に書いてみましょう。
互いに独立な二つの正規分布、
\[
X\sim N(\mu_X,{\sigma_X}^2)
\]
\[
Y\sim N(\mu_Y,{\sigma_Y}^2)
\]
があるとします。
すると、足し算では、
\[
X+Y
\sim
N
\left(
\mu_X+\mu_Y,;
{\sigma_X}^2+{\sigma_Y}^2
\right)
\]
となります。
一方、引き算では、
\[
X-Y
\sim
N
\left(
\mu_X-\mu_Y,;
{\sigma_X}^2+{\sigma_Y}^2
\right)
\]
となります。
| 演算 | 平均 | 分散 |
|---|---|---|
| \[X+Y\] | \[\mu_X+\mu_Y\] | \[{\sigma_X}^2+{\sigma_Y}^2\] |
| \[X-Y\] | \[\mu_X-\mu_Y\] | \[{\sigma_X}^2+{\sigma_Y}^2\] |
 ユキさん
こうして並べるとよく分かります。
平均値の方は普通の足し算、引き算。
でも分散は、どちらの場合も足し算なんですね。
マナブ先生そうです。
これを正規分布の加法性と呼びます。
ただし、今回のように単純に分散を足すためには、
二つの値が互いに独立であるという条件が重要です。
ユキさん独立というのは、
A校のある生徒の点数が高かったからといって、
B校から選んだ生徒の点数が高くなるわけではない、
というような意味ですね。
マナブ先生そう考えればよいでしょう。
もし二つの値の間に関係がある場合には、
その関係も計算に入れる必要があります。
今はまず、
独立な二つのデータなら、分散は足し算
と理解しておきましょう。
なぜ品質管理でこれが重要なのか
ユキさんでも、品質管理では、
この正規分布の足し算や引き算を
どんなときに使うのでしょう?
マナブ先生実は、これから非常によく使います。
例えば、二つの製造方法A、Bについて、
「平均寸法に本当に差があるのか」
を調べたいとします。
そのときに考えるのは、
\[
\mu_A-\mu_B
\]
という平均値の差です。
ユキさんあっ。
平均値同士を引き算するんですね。
マナブ先生そうです。
そして、その「平均との差」そのものにもばらつきがあります。
そのばらつきを計算するときに、今日学んだ考え方が出てきます。
ユキさんつまり、これからやる推定や検定につながるんですか?
マナブ先生その通りです。
さらに、
部品Aの長さと部品Bの長さを足して全長を求める、
二つの測定値の差を求める、
複数の誤差が最終結果にどのくらい影響するか考える、
といった場面にも、この考え方が出てきます。
ユキさん単なる正規分布の計算テクニックではないんですね。
マナブ先生そうです。
品質管理では、
複数のばらつきが組み合わさったとき、
最終結果がどのくらいばらつくのか
を考えることが非常に重要です。
標準偏差はそのまま足さない
マナブ先生では最後に、一つ確認しておきましょう。
標準偏差10と標準偏差15を持つ独立な二つの値を組み合わせたとき、
標準偏差は、
\[
10+15=25
\]
でしょうか?
ユキさん違います。
まず分散にして、
\[
10^2+15^2=325
\]
と足してから、平方根を取ります。
だから、
\[
\sqrt{325}
\approx18.0
\]
ですね。
マナブ先生その通りです。
ここは実務でも間違えやすいポイントです。
標準偏差を直接足すのではなく、まず分散を足す。
そのあと必要なら平方根を取って標準偏差に戻します。
ユキさん前の章で、
「なぜ分散なんて二乗した値を使うのだろう」
と思っていましたけれど、
こういうところでも分散を使う意味が出てくるんですね。
マナブ先生いいところに気づきましたね。
統計では、標準偏差の方が直感的には分かりやすいのですが、
計算上は分散の方が扱いやすい
ことがたくさんあります。
その代表例が、今日の正規分布の加法性です。
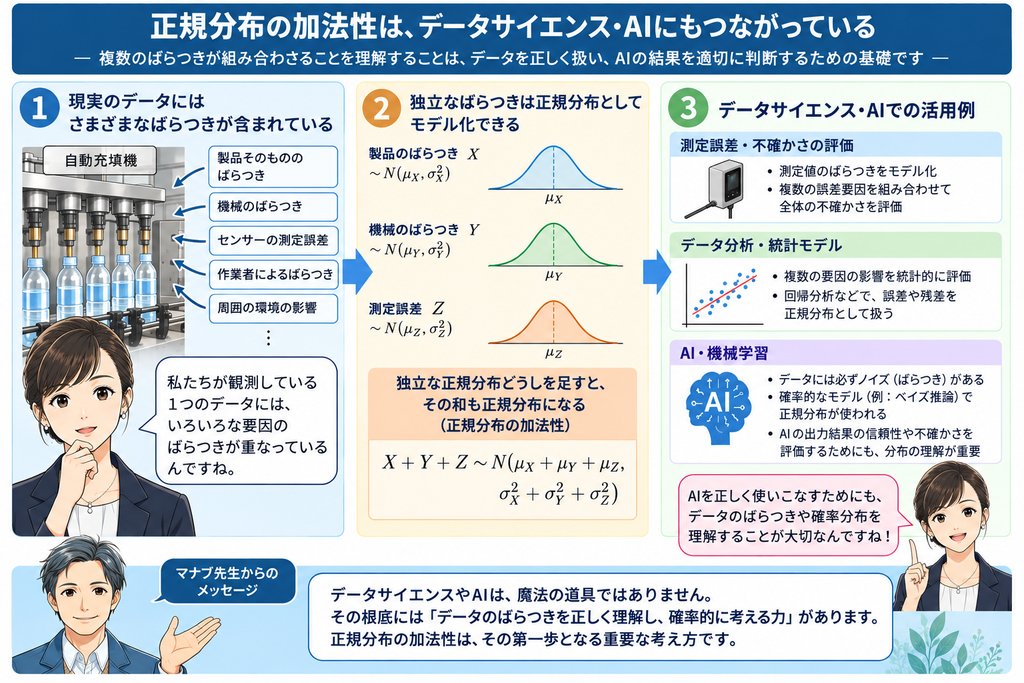
データサイエンスやAIにもつながっている
ユキさん先生、正規分布を足したり引いたりする話って、
品質管理以外でも使われるんですか?
マナブ先生もちろんです。
実は、データサイエンスやAIを理解するときにも
大切な考え方なんです。
ユキさんAIにも正規分布が関係するんですか?
マナブ先生そうです。
例えば、実際のデータにはいろいろな
「ばらつき」や「誤差」が含まれていますよね。
センサーで測定したデータなら、
製品そのもののばらつきだけでなく、
センサーの測定誤差や周囲の環境による変動も
加わっているかもしれません。
ユキさんなるほど。私たちが見ている一つの測定値にも、
いろいろな要因が重なっているということですね。
マナブ先生そうです。
データサイエンスでは、観測されたデータをそのまま見るだけではなく、
「このばらつきは、どのような要因が組み合わさって生じたのだろう?」
と考えることがとても重要なんです。
ユキさんそこで、今日勉強した「正規分布を組み合わせる」という考え方が出てくるんですね。
マナブ先生その通りです。
特に独立した変動要因をモデル化するときには、
それぞれの平均や分散が、
組み合わせた結果にどう影響するのかを考える。
この考え方は、
測定誤差の解析や
不確かさの評価、
統計モデルなど、
いろいろなところにつながっているんですよ。
ユキさんAIというと難しいアルゴリズムを覚えるイメージがありましたが、
その前に
「データがどのようにばらつくのか」
を理解することが大切なんですね。
マナブ先生まさにそこです。
AIはデータからパターンを学習しますが、
そのデータには必ずばらつきやノイズがあります。
だから、AIが出した結果を見る側にも、
データのばらつきや確率分布を理解する力が必要なのです。
ユキさん統計学を勉強することが、
データサイエンスやAIを正しく使うための
基礎になるんですね。
マナブ先生そうですね。
AIが計算してくれる時代だからこそ、
私たちは
「なぜその結果になったのか」
「その結果をどこまで信頼してよいのか」
を考えることがより重要になってきているのです。
今日の内容を整理してみよう
マナブ先生それではユキさん、今日の内容を一度整理してみましょう。
まず、正規分布に従う二つの独立なデータを足したら、
どうなるんでしたっけ?
ユキさんはい。二つのデータがそれぞれ正規分布に従っていて、
互いに独立なら、その和も正規分布になります。
マナブ先生そうですね。では、平均はどうなりますか?
ユキさん平均は、それぞれの平均を足せばいいんですよね。
マナブ先生そのとおり。では、ばらつきは?
ユキさんそこが今日の重要なところでした。
標準偏差をそのまま足すのではなく、分散を足します。
マナブ先生いいですね。
では、二つのデータの「差」を考える場合はどうでしょう?
ユキさん平均は引き算になります。
でも……分散は引かないんですよね?
マナブ先生そのとおり。そこはとても大切ですね。
ユキさん差をとる場合でも、独立していれば分散は足し算になる。
最初はちょっと不思議でした。
マナブ先生そうですね。
でも、「差をとっても、それぞれが持っているばらつきそのものが消えるわけではない」
と考えると理解しやすいです。
ユキさんなるほど。
だから、平均については「足す・引く」を考えて、
ばらつきについては「分散」で考える、と整理すればいいんですね。
マナブ先生いい整理ですね。
そして、この性質はこの後に勉強する統計解析にもつながってきます。
ユキさん例えば、二つのデータの平均を比較するときですか?
マナブ先生そうです。
これから学ぶ「平均の差の推定」や「平均の差の検定」では、
二つの標本平均の差がどのような分布になるのかを考えます。
その土台にあるのが、今日学んだ正規分布の加法性になります。
ユキさんそう考えると、今日の内容だけを覚えるのではなく、
この先の推定や検定につながる考え方として理解しておいた方がよさそうですね。
マナブ先生そのとおり。
では最後に、一言でまとめると?
ユキさんはい。
「正規分布を組み合わせるときは、
平均と分散がどう変化するのかを考える。
特に、ばらつきは標準偏差ではなく分散で考える!」
ですね。
マナブ先生よくできました。
それが今日、一番覚えておいてほしいことですね。
今回のポイント
互いに独立な二つの正規分布、
\[
X\sim N(\mu_X,{\sigma_X}^2)
\]
\[
Y\sim N(\mu_Y,{\sigma_Y}^2)
\]
を考えます。
二つを足すと、
\[
X+Y
\sim
N
\left(
\mu_X+\mu_Y,;
{\sigma_X}^2+{\sigma_Y}^2
\right)
\]
二つを引くと、
\[
X-Y
\sim
N
\left(
\mu_X-\mu_Y,;
{\sigma_X}^2+{\sigma_Y}^2
\right)
\]となります。
つまり、
値を足せば、平均値も足す。
値を引けば、平均値も引く。
しかし、
独立なばらつきは、足し算でも引き算でも分散を足す。
ここが重要です。
そして標準偏差を求める場合には、
\[
\sqrt{{\sigma_X}^2+{\sigma_Y}^2}
\]
と、最後に平方根を取ります。
正規分布の加法性は、これから学ぶ、
平均値の差の推定や検定 を理解するための重要な土台になります。
あなたも考えてみましょう
ある製品は、部品Aと部品Bを直列につないで作られています。
部品Aの長さは、
\[
X\sim N(100,2^2)\ \mathrm{mm}
\]
部品Bの長さは、
\[
Y\sim N(50,3^2)\ \mathrm{mm}
\]
に従い、両者は独立だとします。
完成品の全長、
\[
L=X+Y
\]
の平均値はいくつでしょう?
また、標準偏差はいくつでしょう?
平均値は、
\[
100+50=150\ \mathrm{mm}
\]
分散は、
\[
13\ \mathrm{mm^2}
\]
したがって標準偏差は、
\[
\sqrt{13}
\approx3.61\ \mathrm{mm}
\]
となります。
ここで注目したいのは、
\[
2+3=5\ \mathrm{mm}
\]
ではないということです。
複数の独立したばらつきが組み合わさるときには、
「標準偏差を足す」のではなく、「分散を足す」
のです。
この考え方は、
製品設計における寸法の積み上げや、
測定の不確かさを考える場面
にもつながっていきます。
次回
次回からはいよいよ「推定」の話に入ります。
第4章 標本から母集団を読み解く ― 統計的推定 ―
まずは、
4-1.一部のデータから全体を推定する ― 母集団と点推定 ―
で、推定とは何かについて学びます。
シリーズ全体の目次
『品質をデータで読み解く 統計解析・データサイエンス入門』
― 品質管理の現場で使える「見る・推定する・判断する」ための統計学 ―
全体の目次はここをご覧ください。