統計で最も有名な分布曲線
 マナブ先生
前回は、ヒストグラムを使うと、
数字の並びだけでは分からなかったデータの「形」が見えてくる、
という話をしましたね。
 ユキさん
はい。
データがどこに集まっているのか、
どのくらい広がっているのか、
それから左右対称なのか、
片側に偏っているのか、
といったことを見るんでしたね。
マナブ先生そうですね。
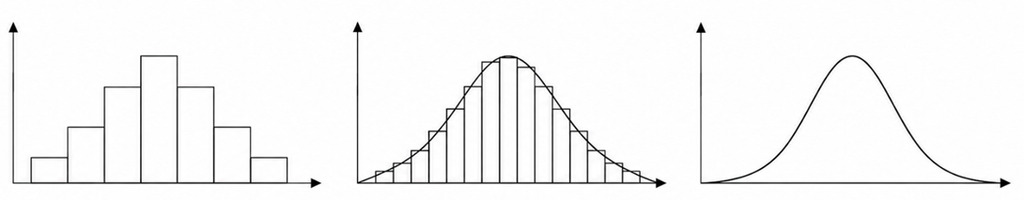
では、データの数をもっともっと増やしたら、
ヒストグラムはどうなると思いますか?
 ユキさん
棒がたくさん並んで、もう少し滑らかな形が見えてきそうです。
マナブ先生そうです。
さらに階級幅を細かくしていくと、
ヒストグラムの輪郭はだんだん滑らかな曲線として
捉えられるようになります。
 マナブ先生
このように、データがどのように分布しているのかを
滑らかな曲線で表したものを、ここでは分布曲線と考えてください。
ではユキさん、統計で最も有名な分布曲線といえば何でしょう?
ユキさん正規分布ですね。
マナブ先生その通りです。
正規分布(normal distribution)です。
なぜ正規分布がよく出てくるのか?
マナブ先生では、正規分布に近い形になりそうなものを何か挙げてみてください。
ユキさん例えば製造業なら、
容器への液体の充填量とか、
切削加工した部品の寸法とかでしょうか。
マナブ先生いいですね。
ほかには?
ユキさん身近なところでは身長、体重などですか。
測定誤差などもそうでしょうか。
マナブ先生そうですね。
多くの小さな要因が重なって結果が決まるような現象では、
正規分布に近い形が現れることがあります。
例えば加工寸法なら、
・材料のばらつき、
・温度、
・工具の状態、
・機械の微小な振動、
・測定誤差、
・作業条件、
といったさまざまな小さな要因が影響します。
ユキさん一つの原因で値が決まっているのではなく、
たくさんの小さな原因が重なっているということですね。
マナブ先生そうです。
ただし、ここは大切ですが、
「自然界のデータは何でも正規分布になる」
という意味ではありません。
右に大きく偏る分布もありますし、山が二つある分布もあります。
品質データについても、
正規分布だと最初から決めつけず、まずデータを見る
ことが重要です。
ユキさん前回のヒストグラムがここにつながるんですね。
マナブ先生その通りです。
正規分布の形を決める2つの数字
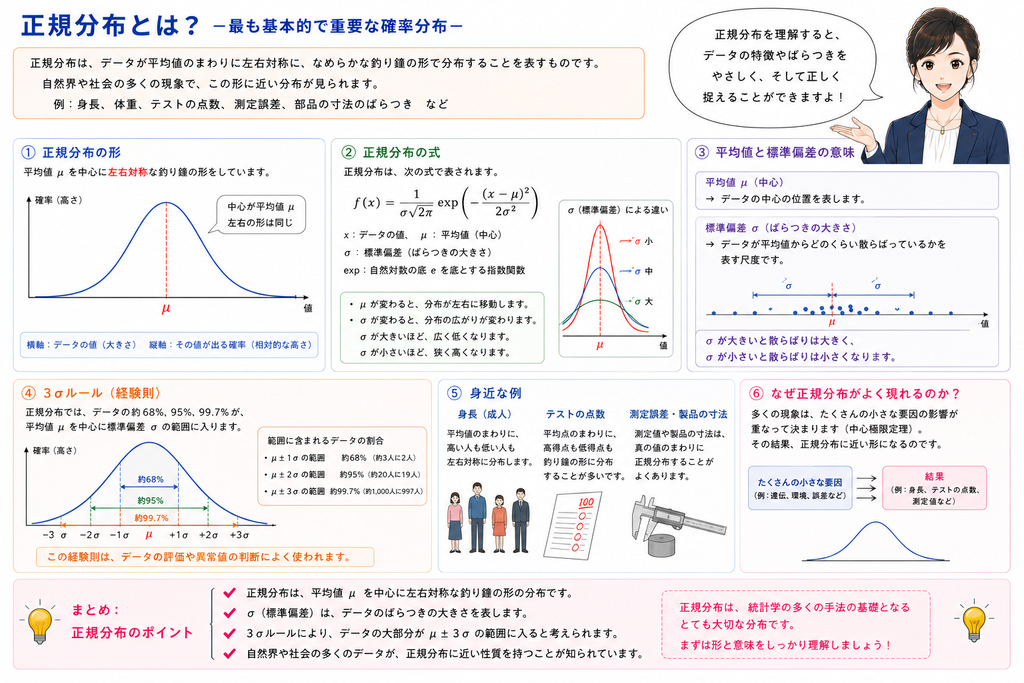
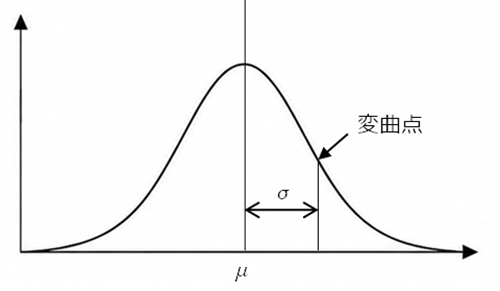
マナブ先生典型的な正規分布は、平均値を\(μ\)、標準偏差を\(σ\)とすると、
こんな釣鐘型の形をしています。
母集団の平均を \(\mu\)、標準偏差を \(\sigma\) とすると、
平均 \(\mu\)、分散 \(\sigma^2\) の正規分布を、
\[
N(\mu,\sigma^2)
\]
と表す。
ユキさん分散が \(\sigma^2\) だから、
2番目には \(\sigma^2\) を書くんですね。
マナブ先生そうです。
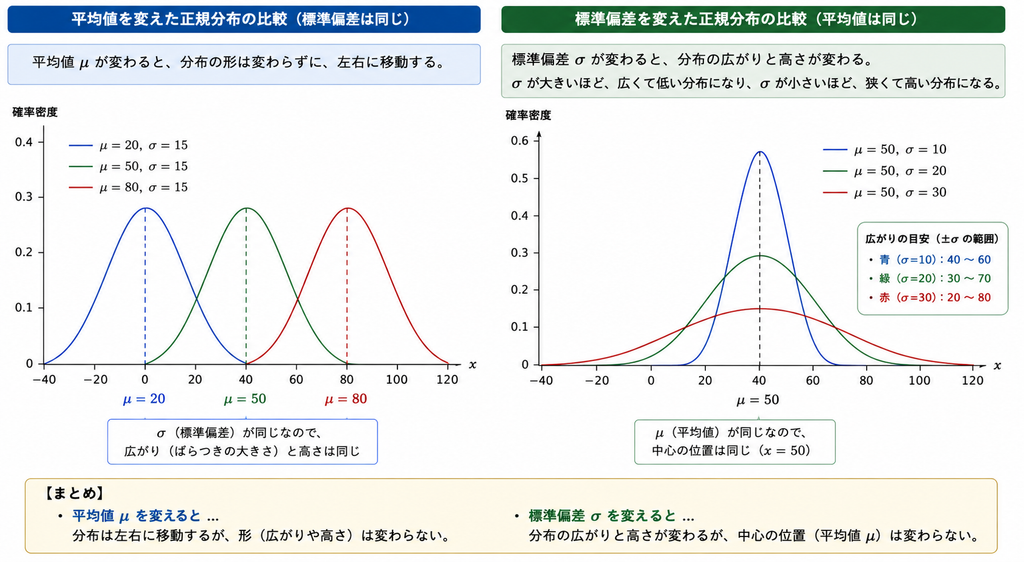
では、平均 \(\mu\) が変わるとグラフはどうなるでしょう?
ユキさん平均値は分布の中心でしたから、
山全体が左右に移動すると思います。
マナブ先生そうですね。
では、標準偏差 \(\sigma\) が大きくなると?
ユキさん標準偏差はばらつきを表すので、横に広がると思います。
マナブ先生その通りです。
つまり、
\(\mu\) は分布の位置を決め、
\(\sigma\) は分布の広がりを決める。
これがまず重要です。
 ユキさん
平均値と標準偏差が、ここでも出てくるんですね。
マナブ先生そうなんです。
第2章で学んだ平均値と標準偏差は、正規分布を理解するための準備でもあったわけです。
なお、正規分布では平均値 \(\mu\) から左右に \(\sigma\) だけ離れた位置が、曲線の曲がり方が変わる変曲点になります。
ユキさんだから正規分布の図で、\(\mu-\sigma\) と \(\mu+\sigma\) がよく書かれているんですね。
あの難しそうな式は必要?
ユキさんでも正規分布って、ものすごく難しい式が出てきますよね。
マナブ先生出てきますね(笑)。
\[
\frac{1}{\sqrt{2\pi}\sigma}
\exp
\left[
-\frac{(x-\mu)^2}{2\sigma^2}
\right]
\]
ユキさんこれです、これ。
初心者を統計学から遠ざける元凶は(笑)。
マナブ先生そう感じる人は多いでしょうね。
でも安心ください。
これから品質管理で推定や検定を使うために、
この式を暗記したり、自分で積分したりする必要はありません。
大切なのは、この式そのものではなく、
正規分布にはどのような性質があるのか
を理解することです。
ユキさんそれなら少し安心しました。
正規分布を全部同じ形にしてしまう
マナブ先生ここで一つ問題があります。
例えば、
平均100 mm、標準偏差2 mmの部品寸法
と、
平均500 mL、標準偏差10 mLの充填量
では、数字も単位も違いますね。
ユキさんはい。
そのままでは比較しにくいですね。
マナブ先生そこで、
どんな正規分布でも同じ物差しで扱えるようにしよう
と考えます。
どんな平均値と標準偏差にすると、一番簡単だと思いますか?
ユキさん平均50、標準偏差10ですか?
マナブ先生いいですね。
それは、学校や受験でよく使われる偏差値の考え方です。
では、数学的にもっと簡単にするなら?
 ユキさん
平均0、標準偏差1ですか?
マナブ先生その通りです。
平均0、標準偏差1になるように変換した正規分布を、
標準正規分布といいます。
平均0、標準偏差1になるように変換した正規分布
\[
N(0,1)
\]
と表します。
どうすれば平均0、標準偏差1になる?
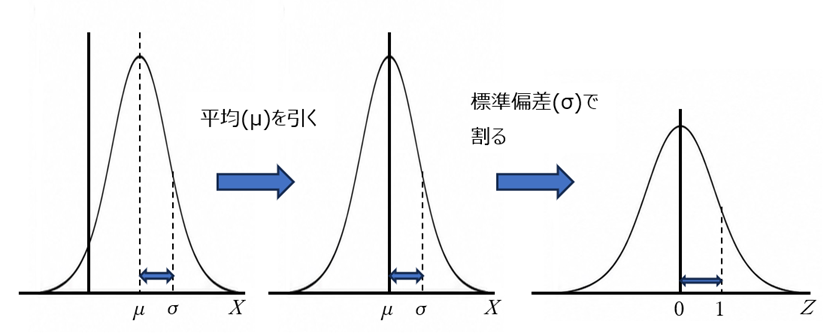
マナブ先生では、正規分布確率密度関数で、
元の値 \(x\) をどのように変換したら、
平均を0にできるでしょう?
ユキさん平均値 \(\mu\) を引けばいいですね。
\[
x-\mu
\]
です。
マナブ先生そうですね。
これで平均からの距離になります。
では、その距離を標準偏差何個分なのかで表したいとしたら?
ユキさん標準偏差 \(\sigma\) で割ればいいですね。
マナブ先生その通りです。
つまり、
\[
\frac{x-\mu}{\sigma}
\]
です。
この操作を標準化といいます。
\[
z=\frac{x-\mu}{\sigma}
\]
 マナブ先生
この変換で得られたものが標準正規分布です。
\[
N(0,1^2)
=\frac{1}{\sqrt{2\pi}}
\exp
\left[
-\frac{z^2}{2}
\right]
\]
マナブ先生随分とすっきりしましたね。
ユキさん私的にはあまりすっきりしていませんけど…
マナブ先生この式もあまり使いません。
平均が0で、標準偏差が1の標準正規分布を
\[N(0,1^2)\]
と表記するということと、
標準化した値 \(z\) は、
「その値が平均から標準偏差何個分離れているか」
を表すことだけを覚えておきましょう。
ユキさんあ、そう考えると \(z\) の意味が分かりやすいですね。
マナブ先生では、
\[
z=1
\]
とは、どういう意味でしょう?
ユキさん平均より標準偏差1個分上。
マナブ先生では、
\[
z=-2
\]
なら?
ユキさん平均より標準偏差2個分下ですね。
マナブ先生それで十分です。
標準化の本質は、
元の単位を、
「平均から標準偏差何個分か」
という共通の物差しに置き換えること
なんです。
実際に標準化してみる
マナブ先生では、前に使ったテストの点数で試してみましょう。
データは、
\[
88, 75, 57, 45, 62, 77, 92, 32, 59, 61
\]
でした。
この10人を一つの集団として計算すると、
平均値は、
\[
\mu=64.8
\]
標準偏差は、
\[
\sigma\approx17.65
\]
でしたね。
では、88点を標準化してみてください。
ユキさんはい。
\[
\frac{88-64.8}{17.65}
\approx1.31
\]
です。
マナブ先生この1.31を日本語で説明すると?
ユキさん88点は、
平均より標準偏差約1.31個分高い
という意味ですね。
マナブ先生そうです。
では、61点は?
ユキさん\[
\frac{61-64.8}{17.65}
\approx-0.22
\]
です。
マイナスになりました。
マナブ先生なぜでしょう?
ユキさん61点は平均64.8点より低いからですね。
つまり、平均より標準偏差0.22個分ほど下ということですね。
マナブ先生その通りです。
偏差値も実は標準化
マナブ先生先ほど偏差値の話をしましたね。
標準化した \(z\) を使うと、偏差値は、
\[
50+10z
\]
と表せます。
ユキさんということは、
\(z=0\) なら偏差値50ですね。
マナブ先生そうです。
では \(z=1\) なら?
ユキさん60です。
マナブ先生つまり偏差値60というのは、
平均より標準偏差1個分高い位置
という意味なんです。
ユキさんそういう意味だったんですね。
偏差値60という数字だけ覚えていました。
マナブ先生では、最高点92点の偏差値も計算してみましょう。
ユキさんまず、
\[
\frac{92-64.8}{17.65}
\approx1.54
\]
なので、偏差値は
65.4
です。
マナブ先生そうですね。
ただし、今回の10人だけで作った平均値と標準偏差なので、
あくまで説明用の例です。
実際の偏差値は、もっと多くの受験者などを基準に計算します。
正規分布の「面積」が確率になる
マナブ先生さて、ここから正規分布のとても重要な性質に入ります。
標準正規分布の曲線と横軸に囲まれた面積を、
全部足すといくつになると思いますか?
ユキさん100%ですか?
マナブ先生そうです。
確率で表せば、
\[
1
\]
です。
つまり、曲線の下の面積を確率として考えることができます。
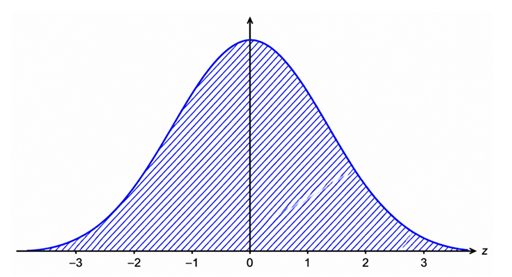 ユキさん
面積が大きいところほど、
その範囲にデータが入る可能性が高いということですね。
マナブ先生その通りです。
これが正規分布を使ううえで非常に重要な考え方です。
±1σ、±2σ、±3σにはどのくらい入る?
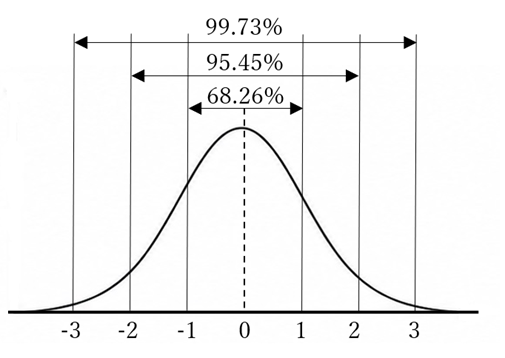
マナブ先生標準正規分布では、
\[
-1\le z\le1
\]
の範囲には、全体のおよそ何%が入ると思いますか?
ユキさん半分よりは多そうですが……70%くらいでしょうか。
マナブ先生かなり近いですね。
実際には約、
\[
68.26%
\]
です。
さらに、
\[
-2\le z\le2
\]
には約、
\[
95.45%
\]
そして、
\[
-3\le z\le3
\]
には約、
\[
99.73%
\]
が入ります。
 ユキさん
3まで行くと、ほとんど全部ですね。
マナブ先生そうですね。
整理すると、
\[
\mu\pm\sigma
\quad\Rightarrow\quad
約68.26%
\]
\[
\mu\pm2\sigma
\quad\Rightarrow\quad
約95.45%
\]
\[
\mu\pm3\sigma
\quad\Rightarrow\quad
約99.73%
\]
です。
この関係は、正規分布を理解するうえで非常に重要です。
ユキさんでは、\(\mu-3\sigma\) から \(\mu+3\sigma\) の外側にあるのは、
\[
100-99.73=0.27%
\]
くらいですね。
マナブ先生そうです。
左右対称ですから、片側だけなら約、
\[
0.135%
\]
です。
ユキさんなるほど。
正規分布なら、平均から\(3σ\)も離れた値はかなり珍しいということですね。
マナブ先生そういう見方ができます。
品質管理で「\(3σ\)」という言葉がよく出てくる背景の一つがここにあります。
データの大部分は\(μ±3σ\)の間に入っています。
これを\(3σ\)ルールと呼ぶ人もいますね。
95%ちょうどなら「2σ」ではない?
ユキさん一つ疑問があります。
\(\pm2\sigma\) だと約95.45%ですよね。
でも推定や検定では「95%」という数字をよく聞きます。
95%ちょうどにしたい場合はどうするのですか?
マナブ先生とても良いところに気づきましたね。
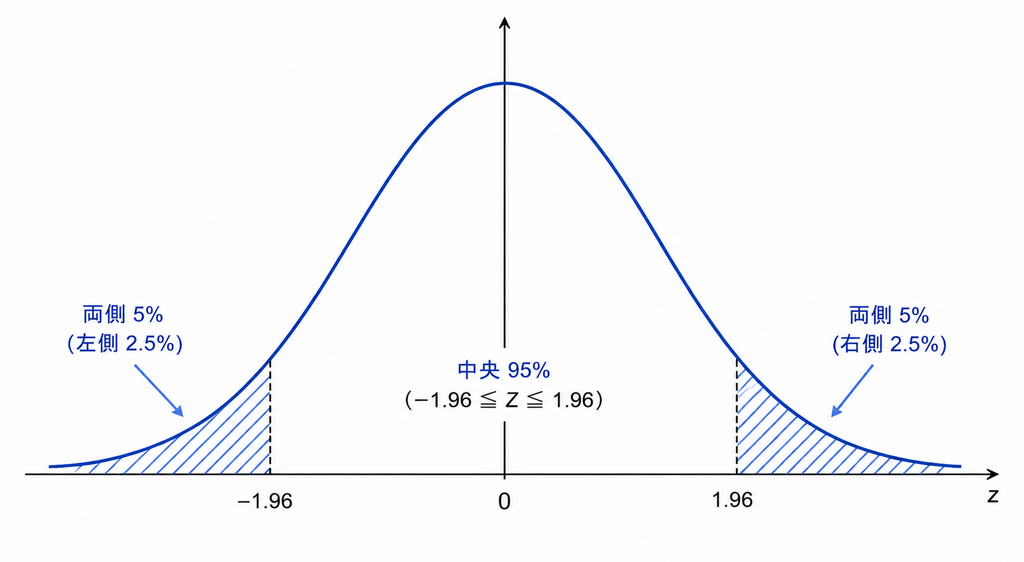
では、中央に95%を残すとしたら、外側には何%残りますか?
ユキさん5%です。
マナブ先生左右対称なので、それぞれ?
ユキさん2.5%ずつです。
マナブ先生そうです。
では、右側に2.5%だけ残る位置を調べると、
\[
z\approx1.96
\]
になります。
したがって中央95%は、
\[
-1.96\le z\le1.96
\]
です。
ユキさんなるほど。
だから推定や検定で1.96がよく出てくるんですね。
マナブ先生そうです。
1.96は突然現れた魔法の数字ではありません。
標準正規分布の中央に95%を残したときの境界
なんです。
推定や検定でよく使う値
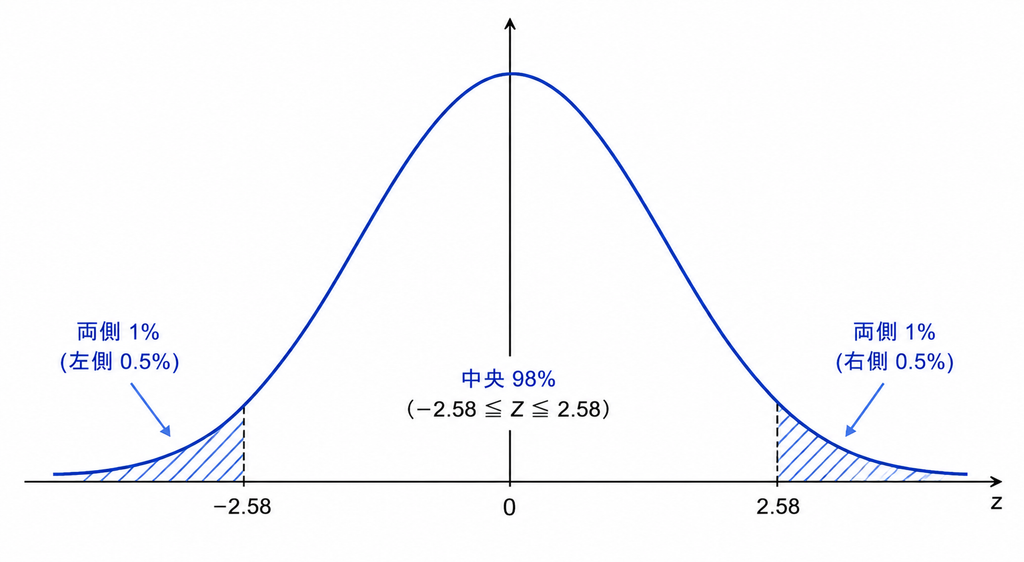
マナブ先生これから行う推定や検定では標準正規分布における両側5%や両側1%、そして上側5%や上側1%というのが良く用いられますが、それを示したのが下の図です。
➀両側5%
②両側1%
③上側5%
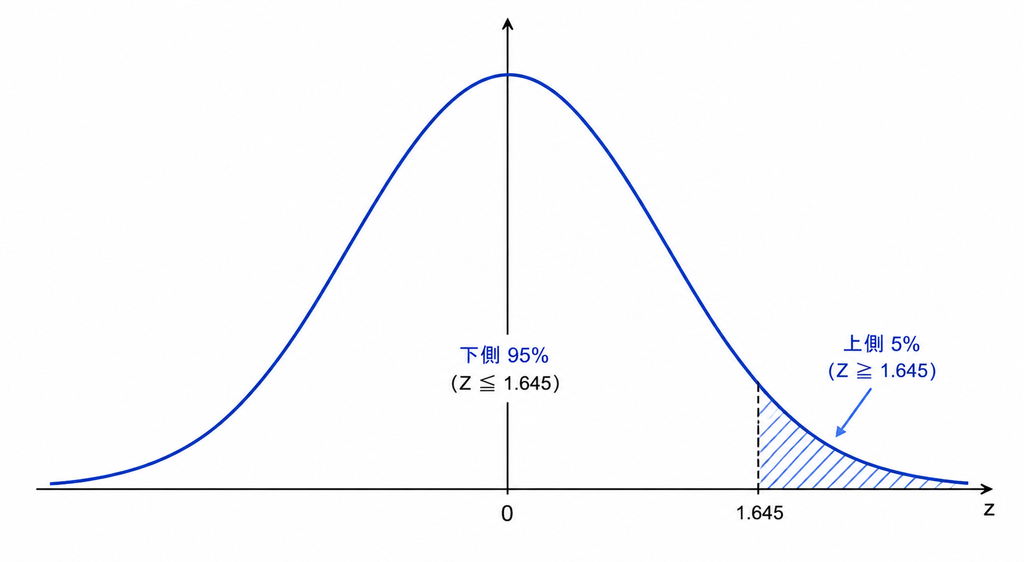
④上側1%
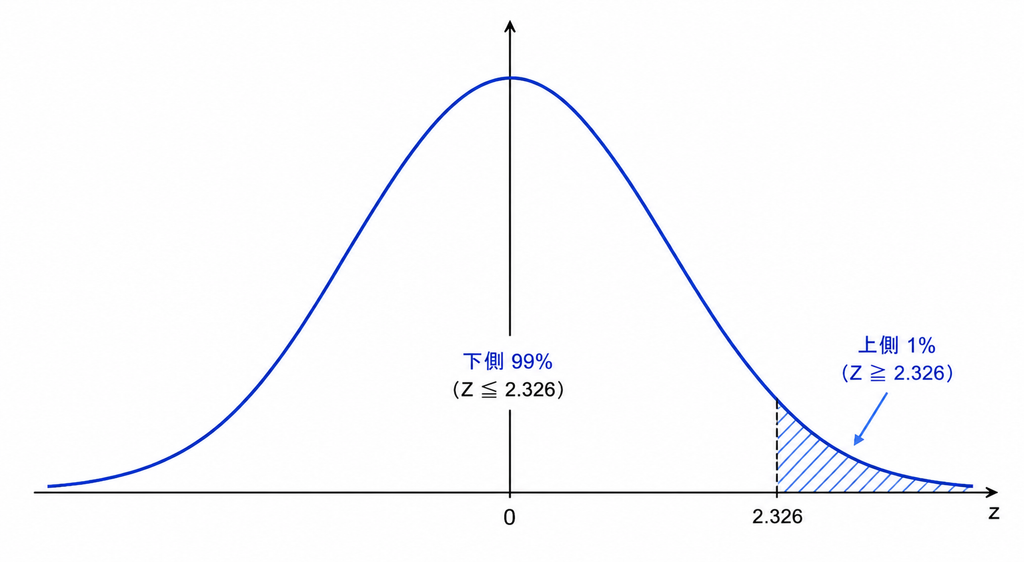 マナブ先生
良く使うので表にまとめておきます。
| 確率 | 標準化された\(z\) |
|---|---|
| 両側5%に入る確率(右側、左側に2.5%) | 1.96 |
| 両側1%に入る確率(右側、左側に0.5%) | 2.58 |
| 上側5%に入る確率 | 1.65 |
| 上側1%に入る確率 | 2.326 |
マナブ先生では、下側5%の境界はどうなりますか?
ユキさん正規分布は左右対称なので、
-1.645
ですね。
マナブ先生その通りです。
ユキさん両側と片側で数字が違う理由も少し分かってきました。
両側5%なら左右に2.5%ずつですが、
上側5%なら右側だけに5%あるからですね。
マナブ先生まさにその理解が大切です。
これが後で、
両側検定と片側検定
を理解するときに効いてきます。
1.96はどうやって求めたの?
ユキさんでも、1.96とか1.645という値は、どうやって求めるんですか?
あの難しい正規分布の式を計算するのでしょうか?
マナブ先生昔は、それを毎回計算するのは大変でした。
そこで、あらかじめ計算した値を表にしたものが作られました。
それが標準正規分布表です。
ユキさん数字がたくさん並んだ、あの表ですね。
マナブ先生そうです。
今回は、ある \(z\) より右側にある面積、
つまり上側確率を示す表を使ってみましょう。
ユキさん……数字だらけで、何を見ればいいのか分かりません。
マナブ先生最初はそう見えますね。
では、
\[
z=1.96
\]
より右側の確率を調べてみましょう。
表の左側で1.9の行を探し、上側で0.06の列を探します。
その交点は何ですか?
ユキさん0.0250です。
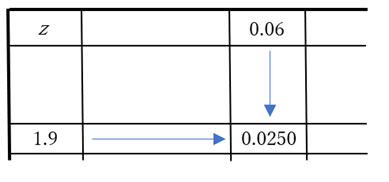 マナブ先生
これは何%ですか?
ユキさん2.50%です。
マナブ先生つまり、
\[
P(Z\ge1.96)\approx0.025
\]
ということです。
左右対称ですから、
\[
P(-1.96\le Z\le1.96)
\]
は?
ユキさん左右に2.5%ずつあるので、
\[
1-0.025-0.025=0.95
\]
つまり95%です。
マナブ先生その通りです。
逆に「5%になる\(z\)」を探してみる
マナブ先生では逆に、
右側に5%が残る \(z\)
を表から探してみましょう。
ユキさん表の中から0.0500に近い値を探せばいいんですね。
マナブ先生そうです。
ユキさん0.0505のところでは \(z=1.64\)、
0.0495のところでは \(z=1.65\) です。
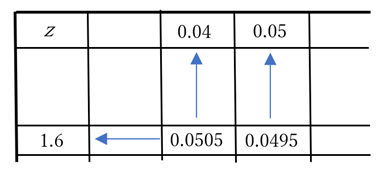 マナブ先生
では、その間くらいですね。
ユキさんちょうど中間なら、
\[
z\approx1.645
\]
ですか?
マナブ先生その通りです。
これが先ほどの、
上側5%点
です。
ユキさん表から1.645が出てくる過程が分かると、
ただ暗記するよりずっと納得できますね。
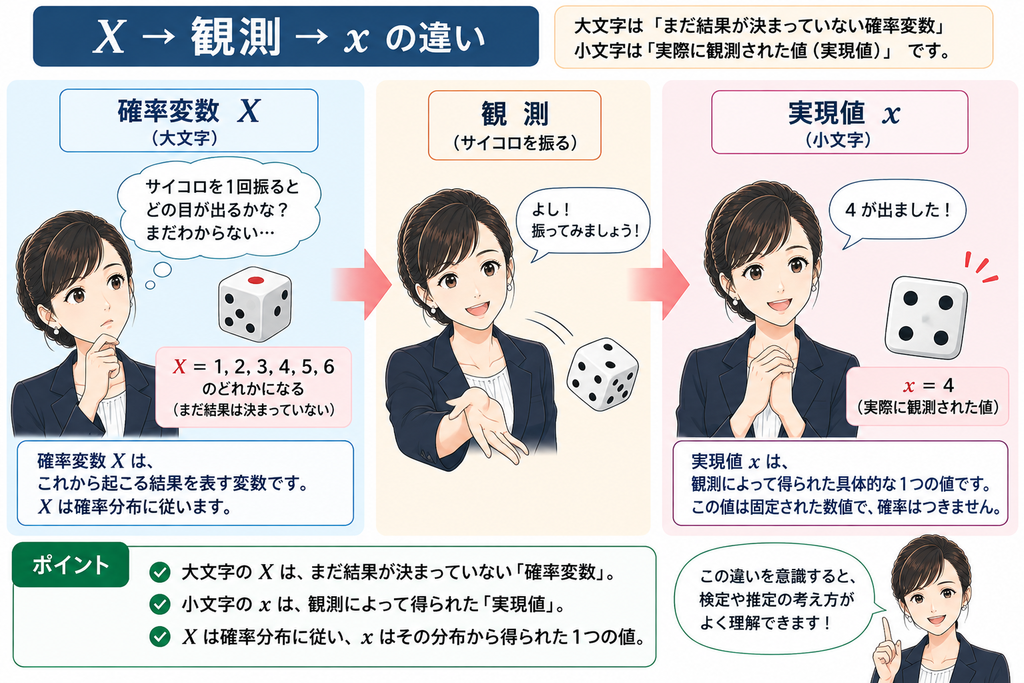
確率変数と実現値
ユキさんただ、マナブ先生の説明でちょっと気になる点がありました。
マナブ先生何ですか?
ユキさん確率を表すときに
\[
P(Z\ge1.96)\approx0.025
\]
と書かれていましたよね。
今まで小文字の\(z\)だったのに、
この式の中には大文字の\(Z\)が使われていますが、
これは何か意味があるのでしょうか?
マナブ先生どうもすみませんでした。
これは確率の専門的な話をするときのルールなのですが、
大文字:まだ結果が決まっていない「変数」
小文字:実際に観測されて決まった「値」
になります。
例えばサイコロを振ると出る目は何ですか??
ユキさん1か2か3か4か5か6です。
マナブ先生それらはまだどの目が出るか決まっていないので、大文字で表します。
例えば、
\[
X=1,2,3,4,5,6
\]
です。
サイコロの場合は、どの目も同じ確率ですので、
この\(X\)は一様分布という確率分布に従い、
\(X\)を確率変数と言います。
そしてサイコロを振ると、ある目が出たとします。
ユキさん例えば4が出たなどですか?
マナブ先生そうです。
その時、実際に出た目は実現値なので
\[
x=4
\]
と小文字で表します。
ユキさん例えば、ある充填機の充填量がある確率分布に従っているとすると、
次に充填される製品の充填量\(X\)は、
この段階では、500.1mLになるのか、
499.8mLになるのかわからないので、
\(X\)は確率変数なのですね。
そして、実際に測定してみると、500.3mLだったとすると、
\(X\)の実現値は
\[
x=500.3mL
\]
となるということですね。
マナブ先生まさにその通りです。
統計では、この2つの世界を行ったり来たりします。
実際に得られた \(x\) から、まだ直接見ることのできない母集団について考えるわけです。
けれど、そこまで厳密に考える必要もありません。
多少混同していても計算そのものには支障がないことが多いです。
これからの説明でも、説明の都合上多少混同している部分も出るかと思いますが、あまり気にしないで、基本的な定義だけ覚えておいてください。
正規分布表は種類が違うことがある
マナブ先生ここで一つ注意があります。
「標準正規分布表」と書いてあっても、
すべて同じ形式とは限りません。
ユキさん違うんですか?
マナブ先生はい。
例えば、
\(z\) より左側全部の確率を載せた表
平均0から \(z\) までの確率を載せた表
\(z\) より右側の確率を載せた表
などがあります。
ですから、表を見るときには、
「この数字は、どこの面積を表しているのか」
を最初に確認することが大切です。
ユキさん同じ \(z=1.96\) でも、表によって載っている数字が違うということですね。
マナブ先生そうです。
表の使い方だけを暗記すると混乱します。
必ず分布の絵を思い浮かべて、
「今求めたいのはどこの面積なのか」
を考えてください。
Excelならもっと簡単に求められる
ユキさん今はExcelで計算できますよね?
マナブ先生もちろんです。
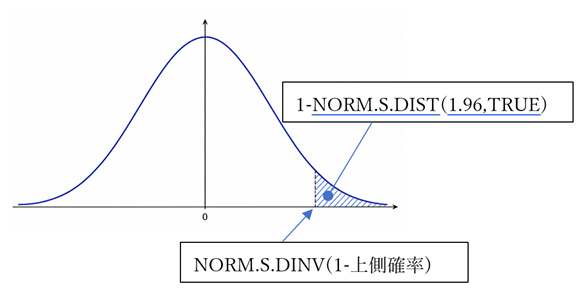
Excelでは標準正規分布について主に次の関数を使います。
| 分布 | 関数 | 機能 |
|---|---|---|
| 標準正規分布 | NORM.S.DIST(z,TRUE) | \(z\) から左側確率を求める |
| NORM.S.INV(左側確率) | 左側確率から \(z\) を求める | |
| 正規分布 | NORM.DIST(x,平均,標準偏差,TRUE) | \(x\) から左側確率を求める |
| NORM.INV(左側確率,平均,標準偏差) | 左側確率から \(x\) を求める |
マナブ先生TRUEは\(z\)あるいは\(x\)以下になる確率を求める時に指定しますので、今の場合ですね。
ここがFALSEになると、\(z\)あるいは\(x\)における確率密度を出力します。
ユキさんExcelは「左側の確率」が基本なんですね。
マナブ先生そうです。
例えば、
\[
z=1.96
\]
より右側の確率を知りたい場合、
NORM.S.DIST(1.96,TRUE)
で得られるのは左側の確率です。
したがって上側確率は、
\[
1-\text{左側確率}
\]
として求めます。
 ユキさん
つまりExcelでも、結局、
どこの面積を求めているのか
を理解していないと間違えるということですね。
マナブ先生まさにそこです。
表を使ってもExcelを使っても、AIに計算させても同じです。
計算そのものはコンピュータがやってくれます。
でも、
「この0.025は何を意味しているのか」
を判断するのは人間です。
AIの時代にも正規分布を学ぶ意味
ユキさんそう考えると、
AIが計算してくれる時代に、
正規分布表の読み方まで覚える必要はあるのでしょうか?
マナブ先生いい質問ですね。
実務で毎回表を引く必要はほとんどありません。
Excelや統計ソフト、Pythonなどで瞬時に計算できます。
ユキさんやっぱりそうですよね。
マナブ先生ただ、
「1.96とは何なのか」
「右側5%とはどの部分なのか」
「両側5%ならなぜ左右2.5%ずつなのか」
が分からなければ、コンピュータの答えを正しく解釈できません。
ユキさん計算方法を覚えるためではなく、
結果の意味を理解するために学ぶんですね。
マナブ先生その通りです。
データサイエンスでもAIでも、
計算できることと、意味を理解して判断できることは別です。
品質管理を担当する技術者に必要なのは、後者です。
今日の内容を整理してみよう
マナブ先生ではユキさん、今日の内容を自分の言葉で整理してみてください。
ユキさんはい。
まず、正規分布は平均値を中心にした左右対称の釣鐘型の分布で、
平均 \(\mu\) と標準偏差 \(\sigma\) によって形が決まります。
マナブ先生そうですね。
ユキさん次に、異なる平均や標準偏差を持つ正規分布を共通の物差しで扱うために、
\[
z=\frac{x-\mu}{\sigma}
\]
で標準化する。
すると平均0、標準偏差1の標準正規分布になります。
マナブ先生いいですね。
ユキさんそして得られた \(z\) は、
平均から標準偏差何個分離れているか
を示しています。
マナブ先生その通りです。
ユキさん正規分布では曲線の下の面積を確率として考えることができて、
\[
\mu\pm\sigma
\]
に約68%、
\[
\mu\pm2\sigma
\]
に約95%、
\[
\mu\pm3\sigma
\]
に約99.7%が入ります。
マナブ先生いいですね。
ユキさんさらに、中央95%に正確に対応するのは、
\[
\mu\pm1.96\sigma
\]
で、この1.96のような値を使って、
これから推定や検定をしていくんですね。
マナブ先生十分です。
では最後に、一つだけ覚えておいてください。
正規分布を学ぶ目的は、
あの難しい式を覚えることではありません。
大切なのは、
「平均からどのくらい離れた値が、どのくらい珍しいのか」
を考えられるようになることです。
この考え方が、これから学ぶ推定や仮説検定の土台になります。
今回のポイント
正規分布は、平均値を中心とした左右対称の釣鐘型の分布です。
平均 \(\mu\)、標準偏差 \(\sigma\) の正規分布は、
\[
N(\mu,\sigma^2)
\]と表します。
平均値 \(\mu\) は分布の位置を、標準偏差 \(\sigma\) は分布の広がりを決めます。
そして、
\[
z=\frac{x-\mu}{\sigma}
\]
によって標準化すると、平均0、標準偏差1の標準正規分布 \(N(0,1)\) に変換できます。
標準化した \(z\) は、
「平均から標準偏差何個分離れているか」
を示しています。
正規分布では、およそ、
\[
\mu\pm\sigma:68.27%\]
\[
\mu\pm2\sigma:95.45%
\]
\[
\mu\pm3\sigma:99.73%
\]
のデータが含まれます。
また推定や検定では、
中央95% → \(z=\pm1.96\)
上側5% → \(z=1.645\)
などが頻繁に使われます。
ただし、大切なのは数値を暗記することではありません。
「分布のどの部分の確率を考えているのか」
を図とともに理解することです。
また、結果が決まっていない確率変数は大文字で表し、
実際に観測された値(実現値)は小文字で表すことも覚えておきましょう。
あなたも考えてみましょう
ある充填工程の充填量が、
平均
\[
\mu=500\ \mathrm{mL}
\]
標準偏差
\[
\sigma=2\ \mathrm{mL}
\]
の正規分布に従っているとします。
ある1本の充填量が、
\[
506\ \mathrm{mL}
\]
だったとしたら、この値は平均から標準偏差何個分離れているでしょう?
\[
\frac{506-500}{2}=3
\]
です。
つまり506 mLは、
平均から\(3σ\)上にある値
です。
正規分布を仮定すると、このような値はかなり珍しいことが分かります。
では品質管理担当者として、この1本を見たとき、
「たまたま起きたばらつき」
と考えるでしょうか。
それとも、
「工程に何か変化が起きているのではないか」
と考えるでしょうか。 この問いが、やがて仮説検定につながっていきます。
次回
次回は
3-2.正規分布を足したり引いたりするとどうなる?
― 正規分布同士の演算 ―
です。
「正規分布」の性質についてさらに深く学んでいきます。
シリーズ全体の目次
『品質をデータで読み解く 統計解析・データサイエンス入門』
― 品質管理の現場で使える「見る・推定する・判断する」ための統計学 ―
全体の目次はここをご覧ください。