「合格」「不合格」を扱う
 マナブ先生
中心極限定理まで来たので、
もう一つ、
品質管理でとてもよく使う分布を見てみましょう。
正規分布とは少し違うタイプの分布です。
例えばユキさん、製造現場でデータを取るとき、
「寸法が何mmだった」
という数値以外に、どんな記録がありますか?
 ユキさん
そうですね。
「合格、不合格」とか、
「良品、不良品」とかでしょうか。
マナブ先生そうですね。
ほかにも、
「故障した、故障していない」
「異常を検出した、検出しなかった」
というデータがあります。
このように、結果が二つに分かれる現象を確率で扱うときに
登場するのが、今日の二項分布(binominal distribution)です。
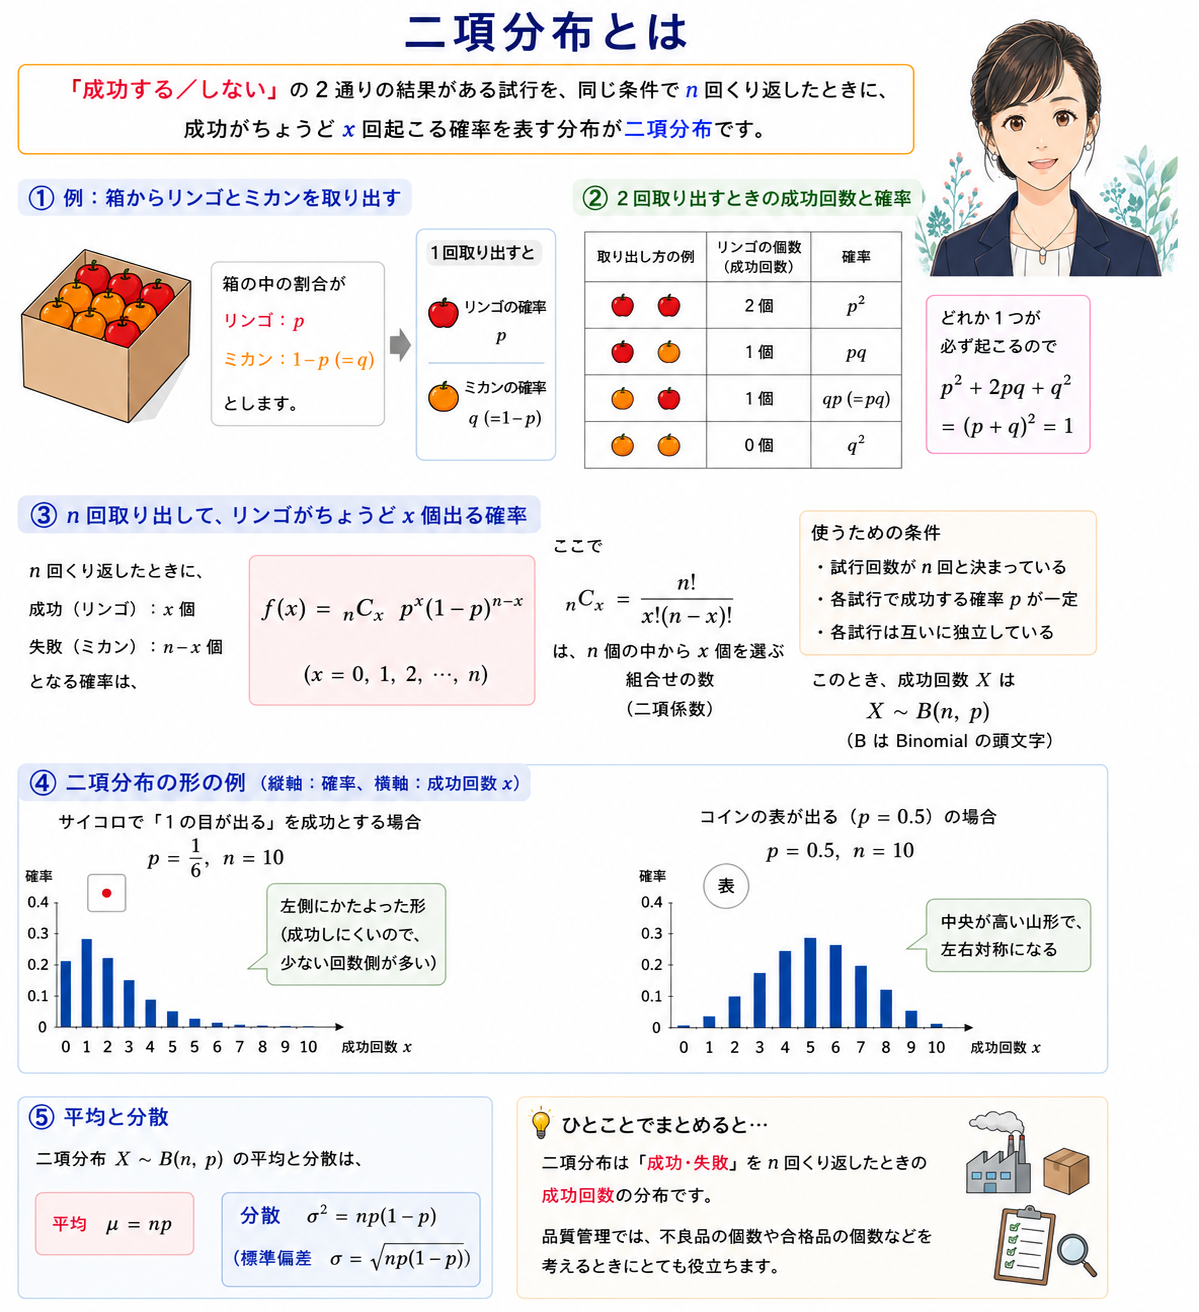
まずはリンゴとミカンで考えてみよう
マナブ先生いきなり品質の話にすると少し固いので、
まずはリンゴとミカンで考えてみましょう。
大きな箱の中に、リンゴとミカンがたくさん入っているとします。
リンゴを取り出す確率を、
$$ p $$
としましょう。
では、ミカンを取り出す確率は?
ユキさん全部で確率1ですから、
$$ 1-p $$
ですね。
マナブ先生そうです。
これを、
$$ q=1-p $$
と置くことにしましょう。
したがって、
$$ \text{リンゴ:}p $$ $$ \text{ミカン:}q $$
です。
ここでは、1個取り出したら元の箱に戻してから
次を取り出すことにします。
そうすれば、毎回、
$$ p,\quad q $$
という確率は変わりません。
ユキさん毎回同じ条件で取り出すわけですね。
マナブ先生そうです。
二項分布では、
各回が独立で、目的とする事象が起こる確率 \(p\) が毎回同じ
ということが重要です。
2回取り出したら何が起こる?
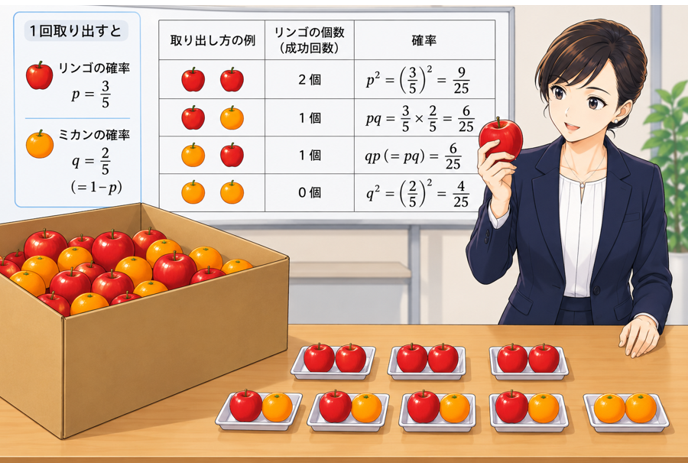
マナブ先生では、2回続けて取り出してみましょう。
どんな組み合わせがありますか?
ユキさん4通りですね。
リンゴ・リンゴ
リンゴ・ミカン
ミカン・リンゴ
ミカン・ミカン
です。
マナブ先生それぞれの確率は?
ユキさん独立なので掛け算をすればいいですね。
リンゴ・リンゴなら、
$$ p\times p=p^2 $$
リンゴ・ミカンなら、
$$ pq $$
ミカン・リンゴなら、
$$ qp $$
ミカン・ミカンなら、
$$ q^2 $$
です。
マナブ先生では、順番ではなく、
「リンゴが何個出たか」
だけに注目して整理してみましょう。
ユキさんリンゴ2個は、
$$ p^2 $$
リンゴ1個は、
リンゴ・ミカンとミカン・リンゴの2通りなので、
$$ 2pq $$
リンゴ0個は、
$$ q^2 $$
です。
 マナブ先生
では、この三つの確率を全部足したら?
ユキさん必ずどれかが起きるので、
$$ p^2+2pq+q^2=1 $$
です。
マナブ先生左辺を見て、どこかで見た形ではありませんか?
 ユキさん
あっ。
$$ p^2+2pq+q^2 = (p+q)^2 $$
ですね。
しかも、
$$ p+q=1 $$
なので、
$$ (p+q)^2=1 $$
です。
マナブ先生そうです。
\(p\)と\(q\)という2つの項がある二項式の展開になっています。
「二項分布」という名前のヒントが見えてきましたね。
3回ならどうなる?
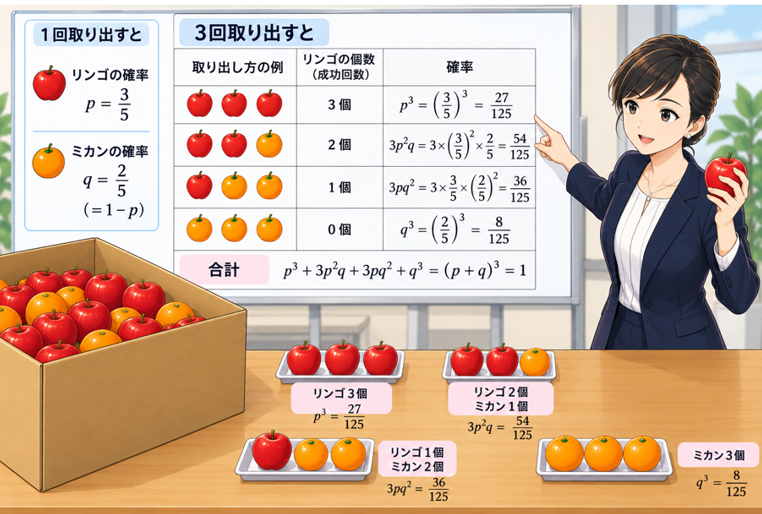
マナブ先生では3回取り出す場合を考えてみましょう。
リンゴが3個の場合は?
ユキさん全部リンゴなので、
$$ p^3 $$
です。
マナブ先生リンゴが2個なら?
ユキさん組み合わせは、
リンゴ・リンゴ・ミカン
リンゴ・ミカン・リンゴ
ミカン・リンゴ・リンゴ
の3通りです。
それぞれの確率は \(p^2q\) なので、
$$ 3p^2q $$
ですね。
マナブ先生ではリンゴ1個は?
ユキさん今度も3通りあるので、
$$ 3pq^2 $$
です。
リンゴ0個なら、
$$ q^3 $$
です。
したがって全部足すと、
$$ p^3+3p^2q+3pq^2+q^3 $$
です。
マナブ先生因数分解すると?
ユキさん$$ (p+q)^3 $$
ですね。
そして \(p+q=1\) だから、
$$ (p+q)^3=1 $$
です。
マナブ先生また二項式の展開が出てきましたね。
\(n\)回行ったら?
マナブ先生では、この操作を4回、5回……と増やして、
全部で \(n\) 回行ったとします。
そのうちリンゴが \(x\) 回出る確率を考えてみましょう。
まず、一つの特定の並び、
例えばリンゴが \(x\) 回、ミカンが \(n-x\) 回出る確率はどうなりますか?
ユキさんリンゴ1回が \(p\)、ミカン1回が \(q\) ですから、
$$ p^xq^{\,n-x} $$
ですね。
マナブ先生そうです。
でも、その並び方は一つだけではありませんね。
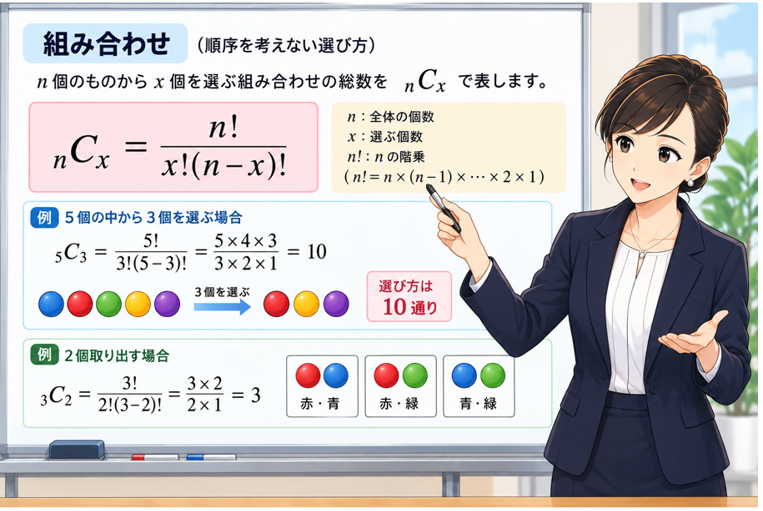
リンゴが \(x\) 回出る並び方は何通りでしょう?
ユキさん\(n\) 個の場所から、リンゴになる \(x\) 個の場所を選ぶので、
$$ {}_nC_x $$
ですね。
 マナブ先生
その通りです。
したがって、
$$ P(X=x) = {}_nC_x p^x (1-p)^{n-x} $$
となります。
ここで、
$$ x=0,1,2,\ldots,n $$
です。
同じ条件の試行を独立に \(n\) 回行い、各回で目的とする事象が起こる確率が \(p\) であるとする。
目的とする事象が起こる回数を \(X\) とすると、
$$ P(X=x) = {}_nC_x p^x(1-p)^{n-x} $$
となる。
このとき、
$$X\sim B(n,p)$$ と表す。
ユキさん最初にこの式だけ見たら難しそうですが、今の流れで見ると、
「1つの並び方の確率」×「その並び方が何通りあるか」
なんですね。
 マナブ先生
まさにそうです。
統計の式も、中身を分解すると意外と単純でしょう。
サイコロを10回振って「1」が出る回数
マナブ先生では実際に二項分布の形を見てみましょう。
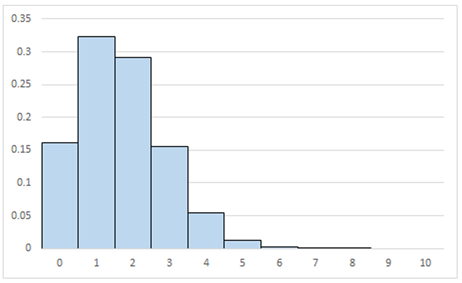
サイコロを10回振ります。
「1が出る」という事象に注目しましょう。
1回の試行で1が出る確率は?
ユキさん$$ p=\frac16 $$
です。
マナブ先生では10回振ったとき、
$$ X\sim B\left(10,\frac16\right) $$
ですね。
 マナブ先生
グラフを見ると、どう感じますか?
ユキさん1回出る確率が一番高いですね。
でも左右対称ではありません。
右側に少し長く伸びています。
マナブ先生そうですね。
実際、
1回出る確率は約、
$$ 0.323 $$
2回出る確率は約、
$$ 0.291 $$
です。
この場合は \(p\) が0.5よりかなり小さいので、
分布は左右対称ではなく、
右側に長い裾を持つ形
になります。
コインを10回投げたら?
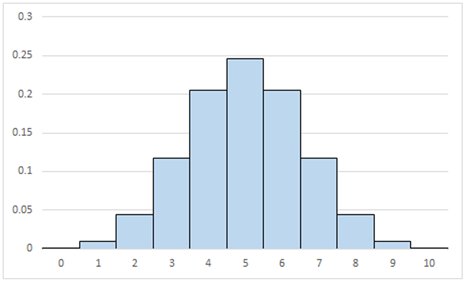
マナブ先生では、今度は公平なコインを10回投げて、
「表が出る回数」
を考えてみましょう。
1回で表が出る確率は?
ユキさん$$ p=0.5 $$
です。
マナブ先生ですから、
$$ X\sim B(10,0.5) $$
ですね。
 マナブ先生
先ほどと比べてどうですか?
 ユキさん
今度は5回を中心に左右対称ですね。
それに……
正規分布の釣鐘型に少し似ています。
マナブ先生そこが面白いところです。
二項分布は離散分布なので棒状ですが、
\(p=0.5\) で \(n\) が大きくなると、見た目は正規分布にかなり近づいていきます。
また正規分布が出てくる
ユキさんここでも正規分布ですか(笑)。
マナブ先生また出てきましたね。
例えば、
$$ X\sim B(n,p) $$
の平均と分散は、
$$ \mu=np $$ $$ \sigma^2=np(1-p) $$
となります。
したがって標準偏差は、
$$ \sigma = \sqrt{np(1-p)} $$
です。
そして \(n\) が大きく、成功と失敗の期待回数、
$$ np $$
と、
$$ n(1-p) $$
の両方が十分大きければ、二項分布は、
$$ N\left(np,\ np(1-p)\right) $$
という正規分布で近似できるようになります。
ユキさん前回の中心極限定理とつながっているんですね。
マナブ先生そうです。
ただし、
「\(n\) が大きければ何でも正規分布で近似できる」
というわけではありません。
例えば \(p\) が非常に小さい場合には、
\(n\) がそこそこ大きくても右に強く歪んだままのことがあります。
ですから実務では、
$$ np $$
と、
$$ n(1-p) $$
が十分大きいかどうかも確認します。
ところでユキさん。
二項分布の平均が、
$$ np $$
というのは、直感的にどう思いますか?
ユキさん例えば不良率が10%なら、
$$ p=0.1 $$
ですよね。
100個調べれば、
$$ 100\times0.1=10 $$
なので、平均的に10個くらい不良が出る。
そう考えれば自然ですね。
マナブ先生その通りです。
二項分布の平均、
$$ \mu=np $$
は、
「n回試したら、平均的に何回起きるか」
を表しています。
品質管理では「リンゴ」より「不良品」
マナブ先生では、品質管理の場面に戻しましょう。
ある製造工程の不良率が、
$$ p=0.02 $$
つまり2%だとします。
そこから100個の製品を無作為に調べます。
不良品の個数 \(x\) は何に従うでしょう?
ユキさん各製品が「不良」か「良品」のどちらかで、
不良になる確率が2%で一定、
それを100回見るので、
$$ X\sim B(100,0.02) $$
ですね。
マナブ先生そうです。
では、不良品数の平均は?
ユキさん$$ np = 100\times0.02 = 2 $$
なので、平均2個です。
マナブ先生そうですね。
ただし、
「必ず2個出る」
という意味ではありません。
0個のこともあれば、1個、3個、4個ということもあります。
その回数と確率の関係を表しているのが二項分布です。
「合格・不合格」なら何でも二項分布?
ユキさんでは、「良品/不良品」のデータなら、
全部二項分布と考えていいのでしょうか?
マナブ先生ここでも条件を確認することが大切です。
二項分布を使う基本条件を考えてみましょう。
まず、1回の結果はいくつですか?
ユキさん2つです。
例えば「不良」か「良品」。
マナブ先生そうですね。
次に、不良になる確率 \(p\) は?
ユキさん毎回同じである必要があります。
マナブ先生そして各製品は?
ユキさん互いに独立に考えられる必要があります。
マナブ先生そうです。
整理すると、基本的には以下のようになります。
- 試行回数 \(n\) が決まっている
- 各試行の結果は2種類
- 目的とする事象が起こる確率 \(p\) が一定
- 各試行が独立
マナブ先生例えば午前中の不良率が1%だったのに、工具が摩耗して午後には10%になっていたとします。
その1日分を全部まとめて、
$$ p=一定 $$
と考えてよいでしょうか?
ユキさん駄目ですね。
不良率が時間によって変わっています。
マナブ先生そうですね。
数式にデータを入れる前に、
「このデータに、本当に二項分布を使ってよいのか」
を考える必要があります。
これは品質管理でもデータサイエンスでも重要な姿勢です。
AIの分類結果も「0か1」
ユキさん二項分布はAIにも関係がありますか?
マナブ先生かなり関係があります。
例えばAIが製品画像を見て、
不良=1
良品=0
と分類するとしましょう。
1製品だけなら結果は0か1です。
こうした1回の試行は、ベルヌーイ試行(Bernoulli trial)と呼ばれます。
このような試行で得られる確率分布が
ベルヌーイ分布(Bernoulli distribution)です。
そして同じ条件のベルヌーイ試行を \(n\) 回繰り返したとき、
「1が何回出るか」
を表すのが二項分布です。
ユキさんということは、
1個について「不良か良品か」を考えるのがベルヌーイ分布、
100個について「不良が何個あるか」を考えるのが二項分布、
という感じでしょうか。
マナブ先生その理解でいいですね。
AIの正解率や検出率などを統計的に評価するときにも、
こうした考え方が土台になります。
今日の内容を整理してみよう
マナブ先生ではユキさん、二項分布を一言で説明してみてください。
ユキさん同じ条件で独立な試行を \(n\) 回行い、
毎回「Aが起こる確率」が \(p\) のとき、
Aが何回起こるか
の確率分布ですね。
マナブ先生式は?
ユキさん$$ P(X=x) = {}_nC_x p^x(1-p)^{n-x} $$
です。
マナブ先生平均と分散は?
ユキさん平均は、
$$ \mu=np$$
分散は、
$$ \sigma^2=np(1-p)$$
マナブ先生では、二項分布が正規分布に近づきやすいのは?
ユキさん\(n\) が大きくなり、
$$ np $$
と、
$$ n(1-p) $$
の両方が十分大きくなったときですね。
マナブ先生十分です。
今回のポイント
二項分布は、
「起こる/起こらない」
「良品/不良品」
「合格/不合格」
のように、
1回の試行の結果が二つに分かれる現象を繰り返したときに使われる重要な確率分布です。
各試行が独立で、
目的とする事象が起こる確率を \(p\)、
試行回数を \(n\) とすると、
その事象が \(x\) 回起こる確率は、
$$ P(X=x) = {}_nC_xp^x(1-p)^{n-x} $$
です。
このとき、
$$ X\sim B(n,p) $$
と表します。
平均と分散は、
$$ \mu=np $$ $$ \sigma^2=np(1-p) $$
です。
そして条件が整えば、\(n\) が大きくなるにつれて、
二項分布は正規分布で近似できるようになります。
品質管理では、不良品数、合格品数、故障件数などを考える際に重要な分布です。
あなたも考えてみましょう
ある製造工程の不良率が、
$$ p=0.03 $$
で安定しているとします。
この工程から、
$$ n=200 $$
個の製品を無作為に取り出します。
不良品数を \(X\) とすると、
$$ X\sim B(200,0.03) $$
です。
平均不良品数は、
$$ np = 200\times0.03 = 6 $$
です。
では実際に検査したところ、
$$ 15個 $$
の不良品が見つかったとしたら、どう考えるでしょう?
「たまたま多く出ただけ」
でしょうか。
それとも、
「不良率3%という従来の工程状態から、何か変化したのではないか」
と考えるでしょうか。
二項分布を使えば、
「15個以上の不良が偶然に出る確率はどのくらいか」
を計算できます。
そしてこの考え方は、このあと学ぶ仮説検定へつながっていきます。
次回
次回は、
4-6.不良率を標本から推定する
― 母比率の推定
です。
シリーズ全体の目次
『品質をデータで読み解く 統計解析・データサイエンス入門』
― 品質管理の現場で使える「見る・推定する・判断する」ための統計学 ―
全体の目次はここをご覧ください。