「データを全部調べる」ことはできる?
 マナブ先生
ここまで、平均値や標準偏差、ヒストグラム、正規分布など
について勉強してきましたね。
ではユキさん、ここまで私たちは、
基本的にどんなデータを扱ってきたでしょう?
 ユキさん
手元にあるデータそのものですね。
平均を求めたり、標準偏差を求めたり、
ヒストグラムを描いたりしました。
マナブ先生そうですね。
つまり、
「目の前にあるデータには、どんな特徴があるのか」
を調べてきたわけです。
では、品質管理の現場で、
本当に知りたいのは手元にあるデータだけでしょうか?
 ユキさん
……違いますね。
例えば製品を10個測定したとしても、
知りたいのはその10個だけではなくて、
工程から作られる製品全体の状態ですよね。
マナブ先生その通りです。
ここから統計学の面白いところに入っていきます。
例えば、ある工場で1日に10万個の部品を製造しているとします。
その部品の寸法について、
「平均寸法はいくつなのか」
を知りたいとします。
どうしますか?
ユキさん10万個全部測れば、本当の平均が分かります。
マナブ先生そうですね。
では、本当に全部測りますか?
ユキさん……現実には大変ですね。
時間も人手もかかります。
マナブ先生もし測定するために製品を壊さなければならない破壊検査だったら?
 ユキさん
全部検査したら、売る製品がなくなってしまいます(笑)。
マナブ先生そうなんです。
そこでどうしますか?
ユキさん全体から一部の製品を取り出して測定します。
マナブ先生そうですね。
そして、その一部のデータから、
「全体はおそらくこうなっているだろう」
と考えます。
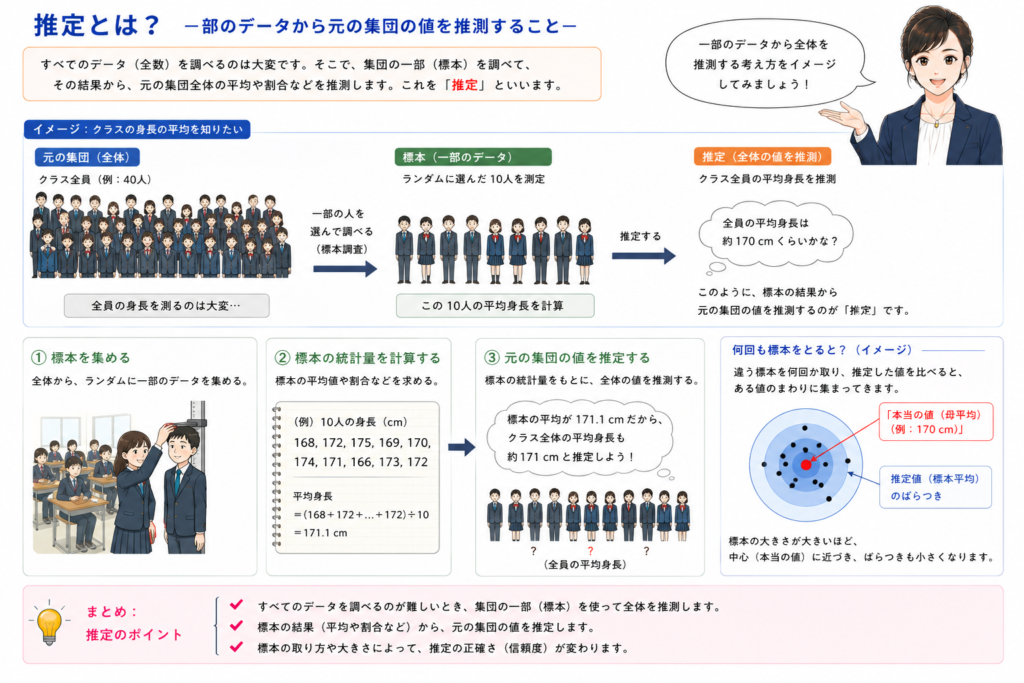
この「全体」を統計学では
「母集団(population)」
と呼びます。
そして、母集団から取り出した一部のデータを
「標本(sample)」
と呼びます。
見えている標本から、見えない母集団を考える
マナブ先生例えば、学年に500人の生徒がいるとしましょう。
この500人全員の数学の点数が母集団です。
そこから10人を選んだとします。
この10人は?
ユキさん標本ですね。
マナブ先生そうです。
その10人の平均点を計算したところ、
$$ \bar{x}=64.8 $$
だったとします。
では、500人全体の平均点は何点くらいだと考えますか?
ユキさんほかに情報がなければ……
64.8点くらいだと考えるしかありませんね。
マナブ先生そうですね。
このように、
標本から得られた情報を使って、
母集団の未知の性質を推測することを
「推定(estimation)」
といいます。
点で推定する : 点推定
マナブ先生今、500人全体の平均点を、
$$ 64.8点 $$
と一つの値で推定しましたね。
このように一つの値、
つまり「点」で母集団の値を推定する方法を、
「点推定(point estimation)」
といいます。
ユキさんなるほど。
点数の「点」ではなく、一つの数値という意味の「点」なんですね。
マナブ先生そういうことです(笑)。
では、ここで一つ質問です。
10人の平均が64.8点だったからといって、
500人全体の平均がぴったり64.8点だと思いますか?
ユキさんそこまでは言えないと思います。
別の10人を選んだら、
平均が63点になるかもしれないし、
67点になるかもしれません。
マナブ先生とても重要なことに気づきましたね。
標本には、
「どの標本を選んだかによるばらつき」
があります。
これを後で詳しく扱います。
範囲を推定する : 区間推定
マナブ先生では、
「学年全体の平均点は64.8点です」
と言い切る代わりに、
どんな表現なら少し安心できそうですか?
ユキさん例えば、
「63点から66点くらいの間だと思います」
のように範囲で示すことでしょうか。
マナブ先生そうです。
これが
「区間推定(interval estimation)」
の考え方です。
例えば、
学年全体の平均点についての95%信頼区間は、
63.6点から66.0点である。
というように表します。
ユキさん点推定では一つの値を示して、
区間推定では幅を持たせて示すんですね。
マナブ先生そうです。
そして区間推定では、
95%信頼区間
99%信頼区間
などがよく使われます。
この95%や99%を
「信頼水準(confidence level)または信頼係数」
と呼びます。
ユキさん95%信頼区間なら、
「母平均がこの範囲に入っている確率が95%」
という意味ですか?
マナブ先生そう言いたくなりますよね。
ただ、統計学では少し注意が必要です。
同じ方法で、
標本を取る → 95%信頼区間を作る
という作業を何度も繰り返すとしましょう。
すると、作られた区間のうち、
長い目で見ると約95%が真の母平均を含むような方法になっています。
これが95%信頼区間の基本的な意味です。
ユキさんなるほど。
一度作った区間について「母平均が95%の確率でここにある」と考えるより、
「この方法で区間を作り続ければ、その約95%が本当の値を捉える」
という意味なんですね。
 マナブ先生
その理解でいいですね。
この意味については、区間推定を実際に計算するときにもう一度考えましょう。
まず母平均を一点で推定してみる
マナブ先生では今日は、まず点推定を考えましょう。
母集団の平均を、
$$ \mu $$
とします。
でも、この \(\mu\) は分かりません。
分からないから標本を取ったわけですね。
ユキさんはい。
マナブ先生標本として、
$$ x_1,x_2,\ldots,x_n $$
が得られたとします。
母平均 \(\mu\) を推定するなら、何を使うのが自然でしょう?
ユキさん標本の平均、
$$ \bar{x} $$
だと思います。
マナブ先生そうですね。
したがって、
$$ \hat{\mu}=\bar{x} $$
と推定します。
ここで \(\hat{\mu}\) の上についている記号を”ハット(hat)”と呼び、
「\(\mu\) の推定値ですよ」
という意味で使います。
一方、
$$ \bar{x} $$
の横線はすでに出てきていますが”バー(bar)”と呼び、平均を意味します。
なぜ標本平均を使っていいの?
マナブ先生でもユキさん。
本当に \(\bar{x}\) を母平均 \(\mu\) の推定値として使っていいのでしょうか?
ユキさん……今さらですか(笑)。
マナブ先生統計では、こういう「本当に?」が大切なんです。
標本平均が64.8点だったとします。
本当の母平均は64.8点より大きいと思いますか?
それとも小さいと思いますか?
ユキさんそれだけでは分かりません。
大きいかもしれないし、小さいかもしれません。
マナブ先生その感覚が大切です。
では、母集団から同じ大きさの標本を何度も無作為に取り出して、
そのたびに標本平均を計算したらどうでしょう。
あるときは母平均より大きくなり、
あるときは小さくなりそうですね。
ユキさんはい。
どちらか一方にいつも偏るわけではなさそうです。
マナブ先生そうです。
実は標本平均 \(\bar{X}\) には、
$$ E(\bar{X})=\mu $$
という性質があります。
ここで\(E\)は\(\bar{X}\)の期待値で、\(\bar{X}\)の平均を表します。
つまり標本平均を繰り返し求めたとき、その平均は真の母平均 \(\mu\) になります。
このように、推定量が系統的に大きい側や小さい側へ偏っていない性質を
「不偏性(unbiasedness)」
といいます。
そして標本平均 \(\bar{X}\) は、母平均 \(\mu\) の不偏推定量(unbiased estimator)です。
ユキさん「不偏」という言葉が、ようやく普通の日本語に見えてきました(笑)。
要するに、
大きいかもしれないし、小さいかもしれない。
つまり大きい確率も小さい確率も同じということで偏りが無い
ということですね。
マナブ先生そうです。
分からない母集団にはギリシャ文字
マナブ先生ところで、統計の本を見ると、
$$ \mu,\quad \sigma,\quad \sigma^2 $$
など、急にギリシャ文字がたくさん出てきますね。
ユキさんそれも統計を難しく見せている原因だと思います(笑)。
マナブ先生でも、ルールが分かると整理できます。
基本的には、
母集団の未知の値にはギリシャ文字
を使います。
例えば、
$$ \mu:母平均 $$ $$ \sigma^2:母分散 $$ $$ \sigma:母標準偏差 $$
です。
一方、
手元にある標本については、
$$ \bar{x}:標本平均 $$ $$ s^2:標本から求める不偏分散 $$ $$ s:標本から求める標準偏差 $$
などを使います。
ユキさん「本当の姿が分かっていない母集団」
と
「手元にある標本」
を、記号でも区別しているんですね。
マナブ先生そう考えると分かりやすいでしょう。
母分散も標本から推定したい
マナブ先生では、母平均だけでなく、
$$ \sigma^2 $$
つまり母分散も推定したいとします。
前に学んだ分散の式を覚えていますか?
ユキさんはい。
データと平均値との差を二乗して全部足して、
データ数で割るんでしたね。
$$ \frac{1}{n} \sum_{i=1}^{n} (x_i-\bar{x})^2 $$
です。
マナブ先生そうですね。
ところが母分散を標本から推定するときには、少し違います。
$$ s^2= \frac{1}{n-1} \sum_{i=1}^{n} (x_i-\bar{x})^2 $$
とします。
$$ n-1 $$で割っていますが、これは
「自由度(degree of freedom)」
と呼ばれています。
ユキさんあれ?
データ数\(n\) ではなく、
$$ n-1 $$
なんですね。
どうしてわざわざデータ数から1を引くのでしょう?
また『自由』という言葉に違和感がありますね。
なぜ \(n-1\) で割るの?
マナブ先生ここが統計の初学者がよく疑問に思うところです。
例えば標本が3個だけだったとして、
$$ x_1,\quad x_2,\quad x_3 $$
があるとしましょう。
標本平均が、
$$ \bar{x}=10 $$
だったとします。
さらに、
$$ x_1=8,\qquad x_2=10 $$
まで分かったら、\(x_3\) は自由に決められるでしょうか?
ユキさん3個の平均が10になるには合計が30なので、
$$ x_3=12 $$
でなければいけません。
マナブ先生そうですね。
つまり3個の値のうち、最初の2個を決めると、
最後の1個は自由には決められません。
ユキさんあっ。
だから『自由度』なんですね。
3個あるけれど、自由に決められるのは2個だけ。
つまり、
$$ 3-1=2 $$
ということですか?
マナブ先生その通りです。
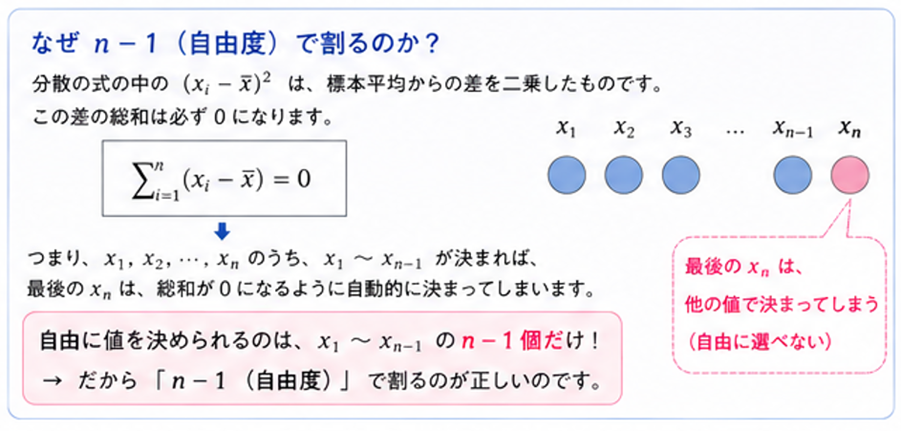
一般に、
$$ \sum_{i=1}^{n}(x_i-\bar{x})=0 $$
という制約があります。
\(n-1\) 個の偏差が決まれば、最後の1個は自動的に決まります。
したがって自由に変化できる情報は、
$$ n-1 $$
個です。
これを「自由度」と呼んでいるのです。
 ユキさん
では、自由度が \(n-1\) だから、分散も \(n-1\) で割るんですね。
マナブ先生方向としてはそうですが、もう一歩だけ考えてみましょう。
本当に知りたいのは母平均 \(\mu\) ですよね。
でも \(\mu\) は分からないので、代わりに何を使いましたか?
ユキさん標本平均 \(\bar{x}\) です。
マナブ先生そうです。
ところが \(\bar{x}\) は、その標本自身から計算されています。
そのため、
$$ x_i-\bar{x} $$
は、本当の母平均 \(\mu\) から測ったばらつきよりも、
平均的には少し小さくなりやすいのです。
ユキさん自分たちのデータから一番真ん中になりそうな \(\bar{x}\) を作って、
そこからの距離を測っているからですね。
マナブ先生その通りです。
そのまま \(n\) で割ると、母分散を平均的に少し小さく見積もってしまいます。
そこで \(n\) より少し小さい、
$$ n-1 $$
で割ることで補正します。
すると、
$$ E(s^2)=\sigma^2 $$
となり、母分散を平均的に正しく推定できるようになります。
これが不偏分散です。
ユキさんなるほど。
単に「自由度だから \(n-1\)」と暗記するより、
標本平均を使ったために小さめに見積もられる分を補正している
と考える方が納得できますね。
マナブ先生その理解が大切です。
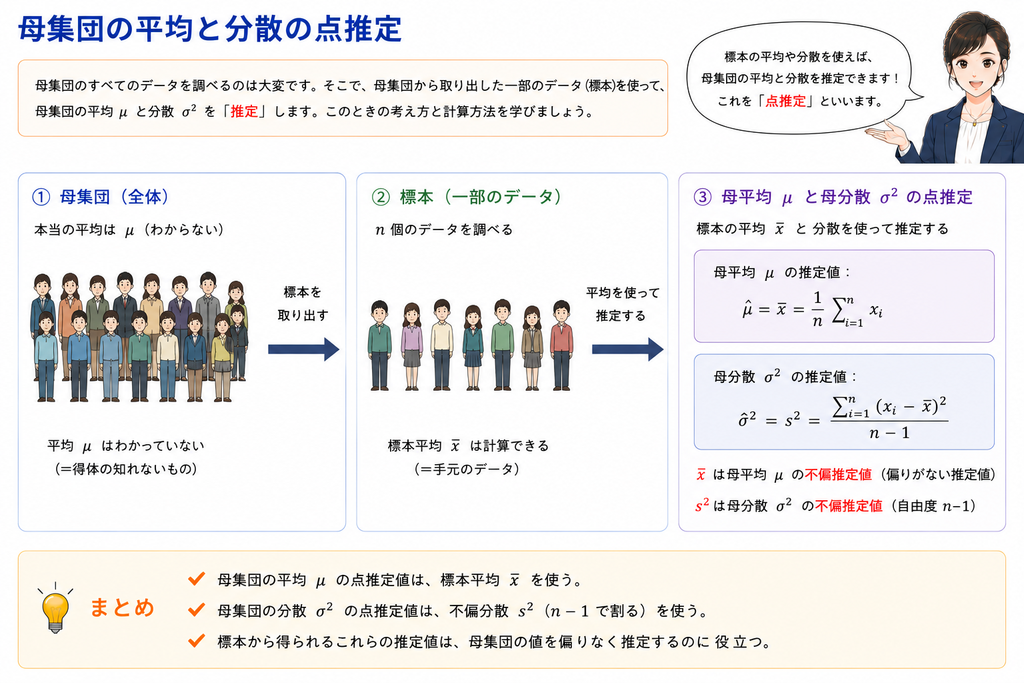
母平均と母分散の点推定を整理しよう
マナブ先生では、ここまでを整理してみましょう。
母平均 \(\mu\) の点推定値は?
ユキさん$$ \hat{\mu}=\bar{x} $$
です。
マナブ先生では母分散 \(\sigma^2\) の点推定値は?
ユキさん$$ \hat{\sigma}^2 = s^2 = \frac{1}{n-1} \sum_{i=1}^{n} (x_i-\bar{x})^2 $$
です。
マナブ先生そうですね。
そして \(s^2\) を不偏分散と呼びます。
標本から母集団を推定するときには、この違いが重要です。
Excelではどう計算する?
ユキさん実務ではExcelを使いますよね。
マナブ先生もちろんです。
現在のExcelなら、標本から不偏分散や標準偏差を求めるときには、
主に次の関数を使います。
| 内容 | 関数名 |
|---|---|
| 標本から求める不偏分散 | VAR.S(範囲) |
| 標本から求める不偏標準偏差 | STDEV.S(範囲) |
マナブ先生既に説明をしましたが、母集団全体のデータが手元にあり、その母集団自体の分散・標準偏差を計算するときは、以下を使います。
| 内容 | 関数名 |
|---|---|
| 母集団の分散 | VAR.P(範囲) |
| 母集団の標準偏差 | STDEV.P(範囲) |
ユキさん.S は標本を意味するSample、
.P は母集団を意味するPopulation
と覚えると分かりやすそうですね。
マナブ先生そうですね。
でも、関数名を覚えることより、
「今持っているデータそのものを記述したいのか」
それとも、
「標本から、その背後にある母集団を推定したいのか」
を区別できることの方が重要です。
AIの時代でも「標本は母集団を代表しているか?」
ユキさんそういえば、データサイエンスやAIでも、
母集団と標本という考え方は使うんですか?
マナブ先生非常に重要です。
例えばAIに1万件の製造データを学習させたとしましょう。
1万件と聞くと、十分多そうに感じますね。
ユキさんはい。10個や100個とは全然違いますから。
マナブ先生でも、その1万件がすべて昼勤のデータだったら?
ユキさん夜勤の状態を反映していないかもしれません。
マナブ先生特定の設備1台だけのデータだったら?
ユキさん別の設備では使えないかもしれません。
マナブ先生そうですね。
つまりデータ数が多いだけでは十分ではありません。
重要なのは、
「その標本は、知りたい母集団をきちんと代表しているのか」
ということです。
ユキさんなるほど。
AIだから統計学が不要になるのではなく、
むしろ大量のデータを扱うからこそ、
「そのデータは何を代表しているのか」
を考える必要があるんですね。
マナブ先生その通りです。
今日の内容を整理してみよう
マナブ先生ではユキさん、今日の内容を自分の言葉でまとめてみてください。
ユキさんまず、調べたい対象全体を母集団、
そこから取り出した一部のデータを標本と呼ぶ。
そして標本から母集団の未知の性質を推測するのが推定です。
マナブ先生そうですね。
ユキさん一つの値で推定するのが点推定。
範囲で推定するのが区間推定。
母平均 \(\mu\) は標本平均 \(\bar{x}\) で推定できる。
マナブ先生では母分散は?
ユキさん標本から母分散を推定するときは、
$$ s^2= \frac{1}{n-1} \sum_{i=1}^{n}(x_i-\bar{x})^2 $$
という不偏分散を使う。
\(n-1\) になるのは、
標本平均を使ったことで自由度が一つ減り、
そのまま \(n\) で割ると母分散を小さめに見積もってしまうからですね。
マナブ先生いいですね。
では、今日一番大切なことは何だと思いますか?
ユキさん手元の標本そのものを知ることと、
標本の向こう側にある母集団について考えることは違う
ということでしょうか。
マナブ先生その通りです。
ここから統計学は、
「見えているデータを整理する学問」から、
「見えている一部のデータから、見えない全体を考える学問」
へ進んでいきます。
今回のポイント
統計的推定では、調べたい対象全体を母集団(population)、
そこから取り出した一部のデータを標本(sample)と呼びます。
標本から母集団の未知の特性を推測することが推定(estimation)です。
一つの値で推定する方法を点推定、範囲で推定する方法を区間推定といいます。
母平均 \(\mu\) の点推定には、
$$ \hat{\mu}=\bar{x} $$
を用います。
標本平均は、
$$ E(\bar{X})=\mu $$
という不偏性を持っています。
一方、母分散 \(\sigma^2\) の推定には、
$$ s^2= \frac{1}{n-1} \sum_{i=1}^{n}(x_i-\bar{x})^2 $$
という不偏分散を用います。
ここで、
$$ n-1 $$
は自由度です。
大切なのは公式を暗記することではなく、
なぜ標本から母集団を推定する必要があるのか
そして、
その標本は本当に母集団を代表しているのか
を考えることです。
これは品質管理だけでなく、
現代のデータサイエンスやAIにおいても極めて重要な考え方です。
あなたも考えてみましょう
ある工場に3台の同型設備A、B、Cがあります。
品質管理担当者が製品寸法を分析するため、1万個のデータを集めました。
ところが、その1万個はすべて設備Aから取得したデータでした。
データ数は十分多そうです。
では、この1万個のデータから、
「この工場で製造される製品全体の寸法分布」
を推定してよいでしょうか?
考えてみてください。
問題なのは、
「データが何個あるか」だけではありません。
「どこから、どのようにデータを取ったのか」
も重要です。
統計的推定では、
標本の大きさと同じくらい、標本の取り方が大切。
この視点を持っておきましょう。
次回
次回は、
4-2.母平均はどこにある?
― 母分散がわかっている場合の区間推定 ―
です。
推定にはいくつかパターンがあります。
それらを一つ一つ解説していきます。
シリーズ全体の目次
『品質をデータで読み解く 統計解析・データサイエンス入門』
― 品質管理の現場で使える「見る・推定する・判断する」ための統計学 ―
全体の目次はここをご覧ください。