母平均はどこにある?
 マナブ先生
前回は、標本から母集団の平均や分散を推定する話をしましたね。
では今日は、もう一歩進めて考えてみましょう。
標本平均を使えば母平均を一点で推定できます。
でも、その値だけを見て、
「母平均はこれです」
と言い切ってよいでしょうか?
 ユキさん
前回の話だと、標本の取り方によって平均値も少し変わりますから、
言い切るのは危ないですね。
マナブ先生そうですね。
そこで今日は、
「母平均はこのあたりにありそうだ」
と、範囲で推定する方法を考えてみます。
まずは標本が1個だけの場合
マナブ先生人の身長は、ある集団では正規分布に近い形になることがあります。
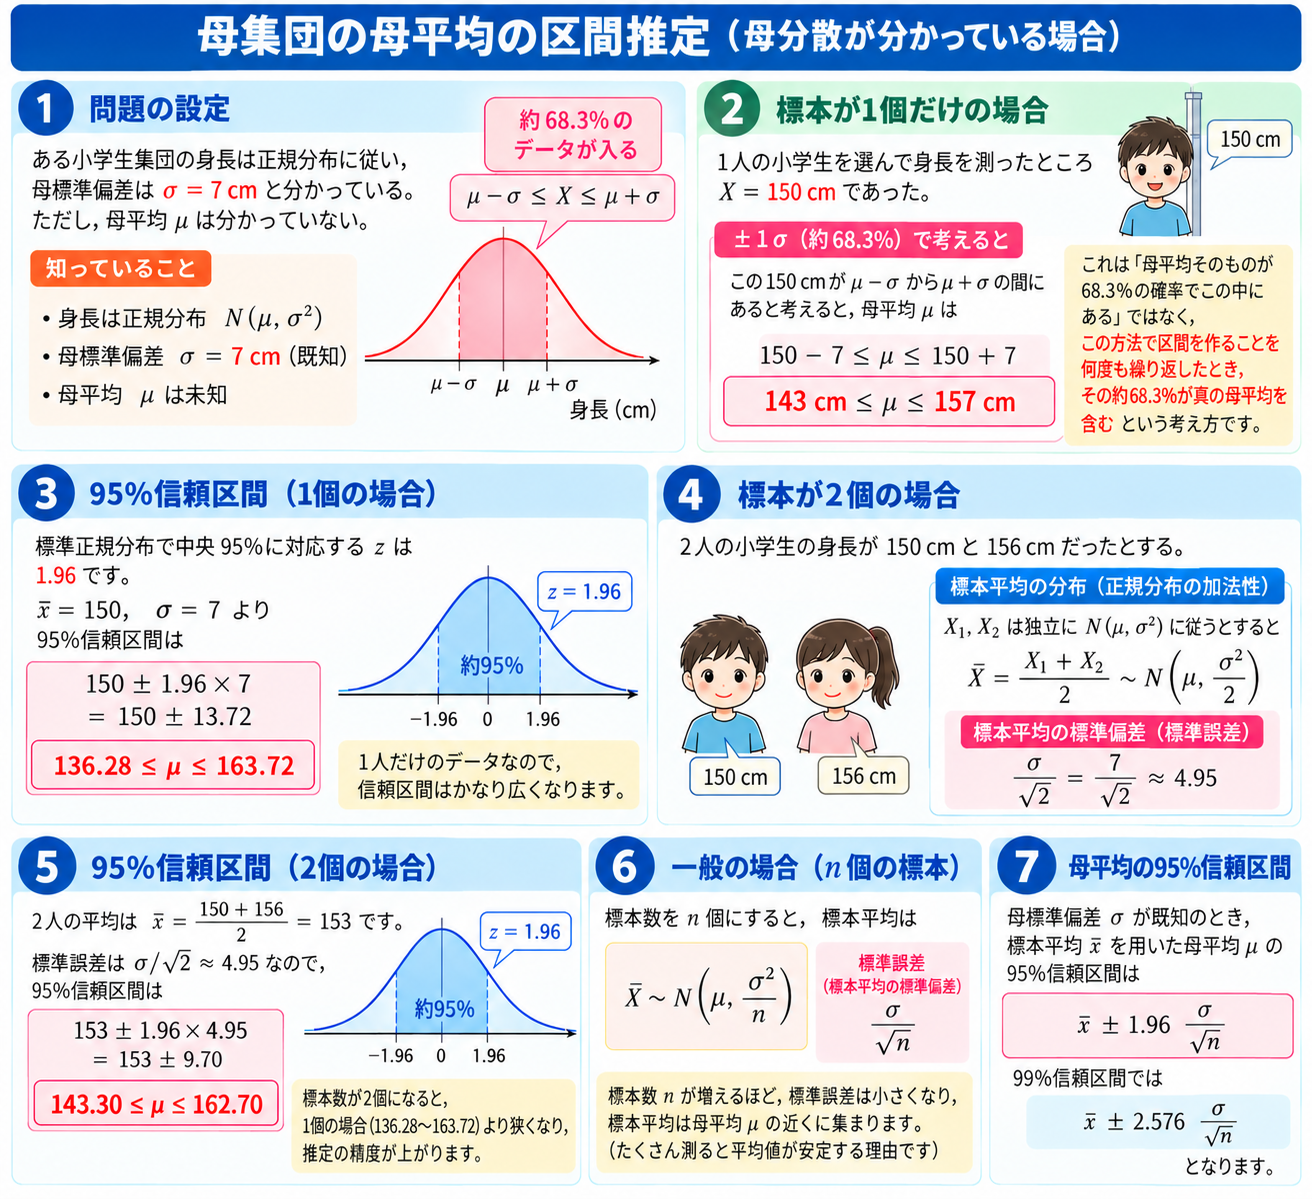
ここでは説明のため、ある小学生集団の身長が正規分布に従い、
母標準偏差が
$$ \sigma=7\ \mathrm{cm} $$
だと分かっているとしましょう。
 マナブ先生
ただし、母平均 \(\mu\) は分かっていません。
ある小学生を1人選んで身長を測ったところ、
$$ 150\ \mathrm{cm} $$
でした。
さてユキさん。
この150 cmという値は、母集団の中でどのあたりにあると思いますか?
ユキさん母平均が分からないので、位置そのものは分かりません。
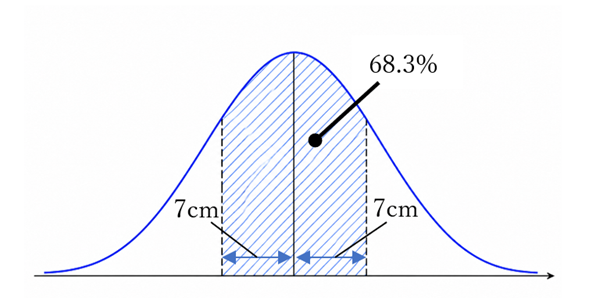
でも正規分布なら、この図のハッチングされている
平均から±1σの範囲に約68.3%のデータが入るんでしたよね。
マナブ先生そうです。
つまり、もし母平均が \(\mu\) なら、
$$ \mu-\sigma \le X \le \mu+\sigma $$
の範囲に約68.3%の観測値が入ります。
では今度は、観測された値が150 cmだったことから、
逆向きに考えてみましょう。
 ユキさん
逆向きですか?
マナブ先生はい。
150 cmという観測値が、母平均から±1σ以内にあると考えるなら、
母平均 \(\mu\) はどのあたりにありそうですか?
ユキさん150 cmを中心にして、±7 cmくらいですか?
つまり、
$$ 143\ \mathrm{cm} \text{から} 157\ \mathrm{cm} $$
くらいですね。
マナブ先生そうですね。
ただし、ここで大切なのは、
「母平均そのものが68.3%の確率でこの中にある」
と読むのではなく、
「この方法で区間を作ることを何度も繰り返したとき、
その約68.3%が真の母平均を含む」
と考えることです。
 ユキさん
前回の信頼区間の考え方と同じですね。
では95%信頼区間なら?
マナブ先生では、95%の信頼区間にしたいとします。
標準正規分布で中央95%に対応する \(z\) はいくつでしたか?
ユキさん$$ 1.96 $$
です。
マナブ先生そうですね。
標本が1個なら、標本平均はその1個の値そのものですから、
$$ \bar{x}=150 $$
です。
また標準偏差は、
$$ \sigma=7 $$
です。
したがって95%信頼区間の幅は、
$$ 1.96\times7=13.72 $$
ですね。
ユキさんすると、
$$ 150-13.72=136.28 $$ $$ 150+13.72=163.72 $$
なので、
$$ 136.28\le \mu \le 163.72 $$
ですね。
マナブ先生そうです。
かなり広い範囲ですね。
ユキさん1人だけのデータですから、仕方ない感じがします。
もう1人測ったらどうなる?
マナブ先生では、もう1人測ってみましょう。
2人目の身長が、
$$ 156\ \mathrm{cm} $$
だったとします。
2人の平均は?
ユキさん$$ \bar{x} = \frac{150+156}{2} = 153 $$
です。
マナブ先生ではここで、前に学んだ正規分布の加法性を使って考えてみましょう。
1人目の身長を \(x_1\)、2人目を \(x_2\) とします。
どちらも同じ母集団から独立に取り出されるので、
$$ X_1\sim N(\mu,\sigma^2) $$
$$ X_2\sim N(\mu,\sigma^2) $$
と考えられます。
では、
$$ X_1+X_2 $$
の平均はどうなりますか?
ユキさん平均は足し算なので、
$$ \mu+\mu=2\mu $$
です。
マナブ先生分散は?
ユキさん独立なら分散も足すので、
$$ \sigma^2+\sigma^2=2\sigma^2 $$
ですね。
マナブ先生そうです。
したがって、
$$ X_1+X_2 \sim N(2\mu,2\sigma^2) $$
です。
では、2人の平均、
$$ \bar{X} = \frac{X_1+X_2}{2} $$
ではどうなるでしょう?
ユキさん平均値そのものは、
$$ \mu $$
ですね。
分散は、全体を2で割るので……
$$ \frac{2\sigma^2}{2^2} = \frac{\sigma^2}{2} $$
ですか?
マナブ先生その通りです。
したがって標準偏差は、
$$ \frac{\sigma}{\sqrt{2}} $$
になります。
ユキさんなるほど。
標本を2個にすると、標本平均のばらつきが小さくなるんですね。
2人のときの95%信頼区間
マナブ先生今回、
$$ \sigma=7 $$
ですから、標本平均の標準偏差は、
$$ \frac{7}{\sqrt{2}} \approx4.95 $$
です。
この値を何と呼ぶか知っていますか?
ユキさん標本平均の標準偏差……ですか?
マナブ先生その通りです。
そして実務では、これを
「標準誤差(standard error)」
と呼びます。
標本平均がどのくらいばらつくかを表す値です。
ユキさん標準偏差とは違うんですね。
 マナブ先生
はい。
標準偏差 \(\sigma\) は個々のデータのばらつき、
標準誤差 \(\sigma/\sqrt{n}\) は標本平均のばらつき
を表します。
ここはとても重要です。
では2人の場合の95%信頼区間を求めてみましょう。
ユキさん幅は、
$$ 1.96\times4.95 \approx9.70 $$
ですね。
平均が153 cmなので、
$$ 153-9.70=143.30 $$ $$ 153+9.70=162.70 $$
です。
したがって、
$$ 143.30\le \mu \le 162.70 $$
ですね。
マナブ先生そうです。
1人のときは、
$$ 136.28\sim163.72 $$
だったのに、2人では、
$$ 143.30\sim162.70 $$
になりました。
どう感じますか?
ユキさんかなり狭くなりました。
標本が増えたので、推定の精度が上がったんですね。
マナブ先生その通りです。
標本数をさらに増やしたら?
マナブ先生では、標本数を2人ではなく、
$$ n $$
人にしたらどうなると思いますか?
ユキさん2人のときが、
$$ \frac{\sigma}{\sqrt{2}} $$
だったので、
$$ \frac{\sigma}{\sqrt{n}} $$
になりそうです。
マナブ先生その通りです。
母集団が、
$$ N(\mu,\sigma^2) $$
に従っているとき、標本平均 \(\bar{x}\) は、
$$ \bar{X} \sim N\left( \mu, \frac{\sigma^2}{n} \right) $$
に従います。
したがって、標本平均の標準偏差、つまり標準誤差は、
$$ \frac{\sigma}{\sqrt{n}} $$
です。
ユキさんつまり、標本数が増えるほど標準誤差は小さくなるんですね。
マナブ先生そうです。
では \(n\) がとても大きくなったら?
ユキさん$$ \frac{\sigma}{\sqrt{n}} $$
は0に近づきます。
つまり、標本平均のばらつきがどんどん小さくなる。
マナブ先生それは何を意味していますか?
ユキさん標本数を多くすれば、
標本平均が母平均 \(\mu\) の近くに集まる
ということですね。
マナブ先生そうです。
これが、
「たくさん測ると平均値が安定する」
理由です。
母平均の95%信頼区間
マナブ先生ここまで来れば、一般式も自然に作れます。
母標準偏差 \(\sigma\) が分かっているとき、
標本平均は、
$$ \bar{X} \sim N\left( \mu, \frac{\sigma^2}{n} \right) $$
です。
標準化するとどうなりますか?
ユキさん標本平均から母平均を引いて、
標本平均の標準偏差で割るので、
$$ Z = \frac{\bar{X}-\mu} {\sigma/\sqrt{n}} $$
ですね。
マナブ先生そうです。
この \(Z\) は標準正規分布、
$$ N(0,1) $$
に従います。
では中央95%に入る条件は?
ユキさん$$ -1.96 \le Z \le 1.96 $$
です。
マナブ先生したがって、
$$ -1.96 \le \frac{\bar{X}-\mu} {\sigma/\sqrt{n}} \le 1.96 $$
ですね。
これを \(\mu\) について解くと?
ユキさん$$ \bar{x} – 1.96\frac{\sigma}{\sqrt{n}} \le \mu \le \bar{x} + 1.96\frac{\sigma}{\sqrt{n}} $$
になります。
マナブ先生その通りです。
これが、母分散が既知の場合の母平均の95%信頼区間です。
母集団が正規分布、
$$ N(\mu,\sigma^2) $$
に従い、母標準偏差 \(\sigma\) が既知であるとき、
標本平均 \(\bar{x}\) を用いた母平均 \(\mu\) の95%信頼区間は、
$$ \bar{x} \pm 1.96 \frac{\sigma}{\sqrt{n}} $$
です。
99%信頼区間では、
$$ \bar{x} \pm 2.576 \frac{\sigma}{\sqrt{n}} $$ となります。
95%信頼区間の「95%」をもう一度確認
ユキさんここで確認ですが、
この区間の中に母平均が95%の確率で入る、
という言い方はしないんでしたね。
マナブ先生そうですね。
頻度論では、母平均 \(\mu\) は固定された未知の値です。
標本を取るたびに変わるのは、
$$ \bar{x} $$
そして、それを使って作る信頼区間の方です。
ユキさんつまり、何度も標本を取り直して95%信頼区間を作ると、
そのうち約95%の区間が真の母平均を含む。
マナブ先生その通りです。
この感覚を持っておけば、信頼区間を誤解しにくくなります。
標本数が増えると、なぜ信頼区間が狭くなる?
マナブ先生では95%信頼区間の式をもう一度見てください。
$$ \bar{x} \pm 1.96 \frac{\sigma}{\sqrt{n}} $$
この式の中で、私たちが増やせるものは何でしょう?
ユキさん標本数 \(n\) ですね。
マナブ先生\(n\) を4倍にしたら、
$$ \sqrt{n} $$
はどうなりますか?
ユキさん2倍になります。
だから、
$$ \frac{\sigma}{\sqrt{n}} $$
は半分になります。
マナブ先生つまり?
ユキさん信頼区間の幅も半分になります。
マナブ先生そうです。
ここは品質管理の実務でも重要です。
推定精度を2倍にしたいなら、標本数は2倍ではなく4倍必要になる
ということです。
ユキさんなるほど。
たくさんデータを集めればいいとはいっても、
精度を上げるにはかなり標本数が必要なんですね。
AIやデータサイエンスとのつながり
ユキさんこの「標本数が増えると推定が安定する」という話は、
AIでも同じなんですか?
マナブ先生基本的な考え方はつながっています。
データが増えることで、偶然のばらつきの影響を小さくできる場面は多くあります。
ただし、前回の話を覚えていますか?
ユキさん「データが多いだけでは十分ではない」という話ですね。
マナブ先生そうです。
100万件あっても偏った標本なら、
間違った母集団を見ている可能性があります。
ですからデータサイエンスでは、
標本数が十分か
だけではなく、
その標本が母集団を代表しているか
も同時に考える必要があります。
今日の内容を整理してみよう
マナブ先生ではユキさん、今日の一番重要な式は何でしょう?
ユキさん標本平均の標準誤差、
$$ \frac{\sigma}{\sqrt{n}} $$
だと思います。
マナブ先生いいですね。
これは何を表していますか?
ユキさん個々のデータのばらつきではなく、
標本平均がどのくらいばらつくか
です。
マナブ先生では、標本数が増えると?
ユキさん標準誤差が小さくなり、信頼区間も狭くなる。
つまり、母平均をより精度よく推定できるようになります。
マナブ先生その通りです。
そして95%信頼区間は、
$$ \bar{x} \pm 1.96 \frac{\sigma}{\sqrt{n}} $$
ですね。
今回のポイント
母標準偏差 \(\sigma\) が分かっている場合、標本平均 \(\bar{X}\) は、
$$ \bar{X} \sim N\left( \mu,\frac{\sigma^2}{n} \right) $$
に従います。
したがって標本平均の標準偏差、つまり標準誤差は、
$$ \frac{\sigma}{\sqrt{n}} $$
です。
標本数 \(n\) が増えるほど標準誤差は小さくなり、標本平均は母平均の近くに集まりやすくなります。
母標準偏差が既知の場合の
95%信頼区間は、
$$ \bar{x} \pm 1.96 \frac{\sigma}{\sqrt{n}} $$
99%信頼区間は、
$$ \bar{x} \pm 2.576 \frac{\sigma}{\sqrt{n}} $$
です。
そして95%信頼区間の「95%」とは、
同じ方法で標本抽出と区間推定を何度も繰り返したとき、作られた区間の約95%が真の母平均を含む
という意味です。
あなたも考えてみましょう
ある充填工程では、過去の十分なデータから母標準偏差が、
$$ \sigma=4\ \mathrm{mL} $$
と分かっています。
16本を無作為に取り出して測定したところ、平均充填量は、
$$ \bar{x}=500.5\ \mathrm{mL} $$
でした。
標準誤差は、
$$ \frac{4}{\sqrt{16}} = 1\ \mathrm{mL} $$
です。
したがって95%信頼区間は、
$$ 500.5 \pm 1.96\times1 $$
なので、
$$ 498.54\ \mathrm{mL} \le \mu \le 502.46\ \mathrm{mL} $$
となります。
では、信頼区間の幅を今の半分程度にしたい場合、標本数は何本くらい必要でしょう?
ヒントは、
$$ \frac{\sigma}{\sqrt{n}} $$ です。
次回
次回は、
4-3.母分散がわからなくても推定できる
― t分布を使った母平均の区間推定 ―
です。
推定にはいくつかパターンがあります。
それらを一つ一つ解説していきます。
シリーズ全体の目次
『品質をデータで読み解く 統計解析・データサイエンス入門』
― 品質管理の現場で使える「見る・推定する・判断する」ための統計学 ―
全体の目次はここをご覧ください。