母標準偏差が分からない方が多い
 マナブ先生
前回は、母集団の標準偏差 \(\sigma\) が分かっている場合の
母平均の区間推定を考えましたね。
95%信頼区間は、
$$ \bar{x} \pm 1.96\frac{\sigma}{\sqrt{n}} $$
でした。
 ユキさん
はい。
でも、実際の仕事では母平均が分からないのに、
母標準偏差だけ分かっているという状況は、
あまり多くなさそうですね。
マナブ先生まさにそこです。
品質管理の現場で新しい工程を調べるとき、
「母平均は分かりません。でも母標準偏差は正確に分かっています」
ということは、それほど多くありません。
では、母標準偏差 \(\sigma\) が分からなかったら、
代わりに何を使えばよいでしょう?
ユキさん前回勉強した標本の標準偏差 \(s\) でしょうか?
マナブ先生そうですね。
標本から求めた不偏分散 \(s^2\)、そしてその平方根である \(s\) を使います。
ただし、一つ問題があります。
\(\sigma\) の代わりに \(s\) を使って大丈夫?
マナブ先生例えば、同じ母集団から10個の標本を取り、
$$ s=5 $$
だったとします。
別の10個を取り直したら、同じ \(s=5\) になるでしょうか?
ユキさんならないと思います。
標本が変われば、標準偏差も少し変わりますよね。
マナブ先生そうです。
母標準偏差 \(\sigma\) は母集団に固有の値ですが、
標本標準偏差 \(s\) は標本によってばらつきます。
つまり、
$$ \frac{\bar{X}-\mu}{\sigma/\sqrt{n}} $$
で使っていた確かな \(\sigma\) の代わりに、不確かな \(s\) を使うことになります。
ユキさんということは、前と同じ標準正規分布をそのまま使うと、
少し自信を持ちすぎることになりそうですね。
マナブ先生とてもいい表現です。
その「追加の不確かさ」を反映した分布が、
「\(t\)分布(t distribution)」
です。
\(t\)分布とは?
ユキさん\(t\)分布も釣鐘型なんですか?
マナブ先生はい。
中心は0で左右対称です。
見た目は標準正規分布によく似ています。
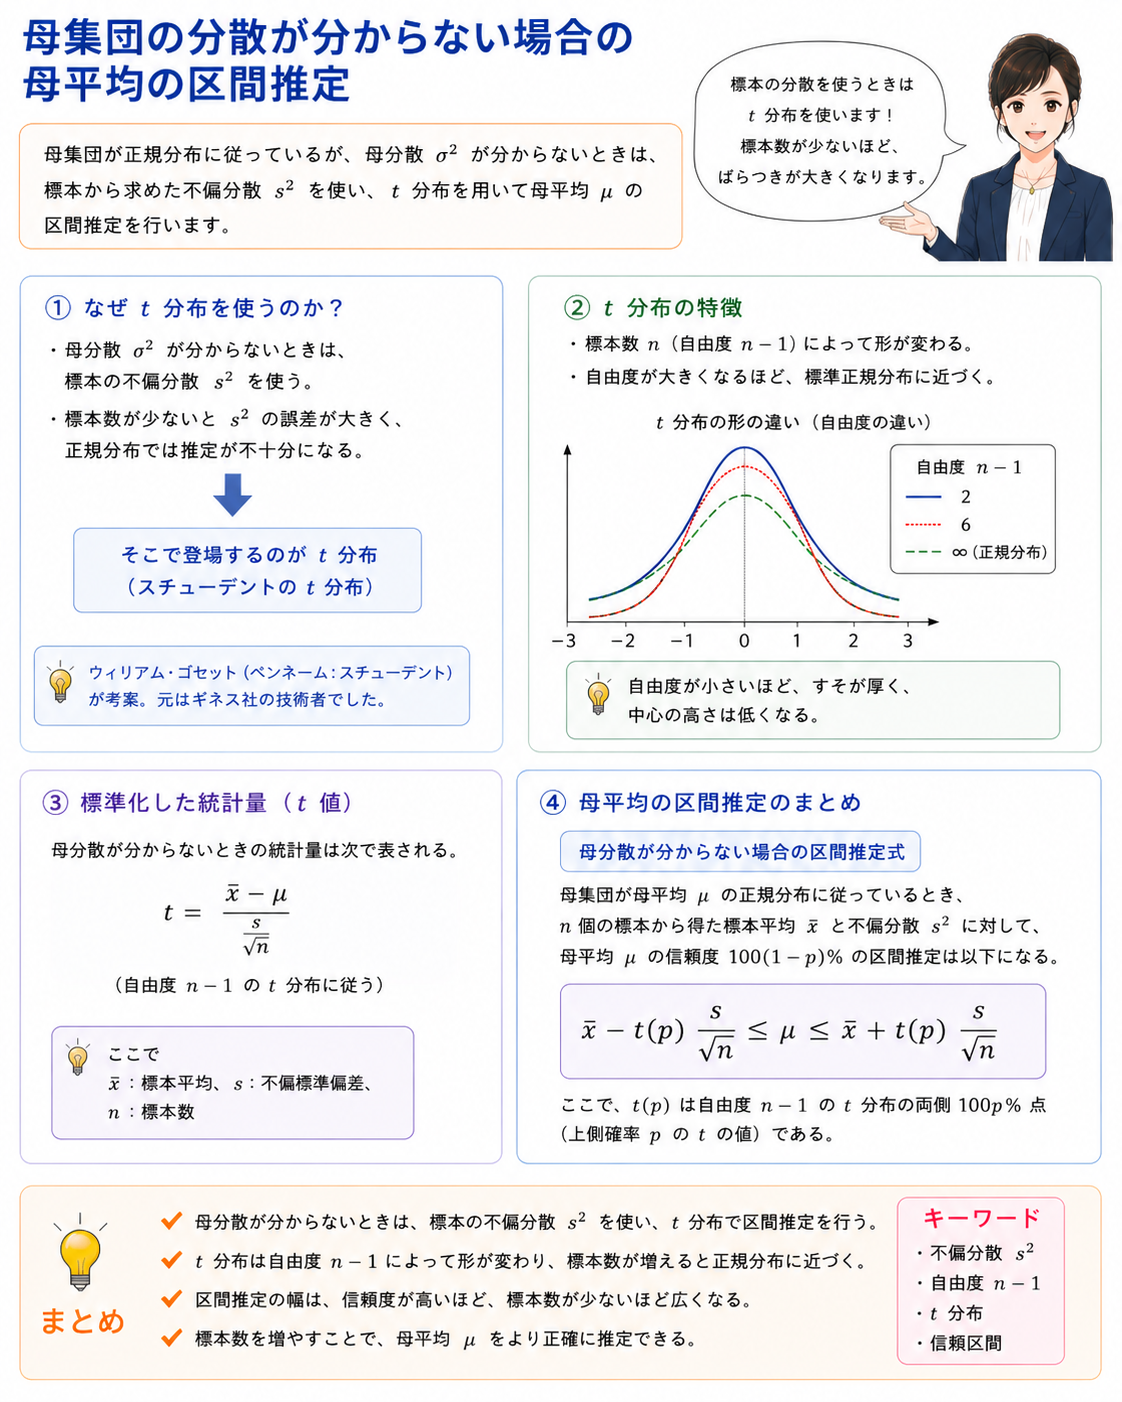
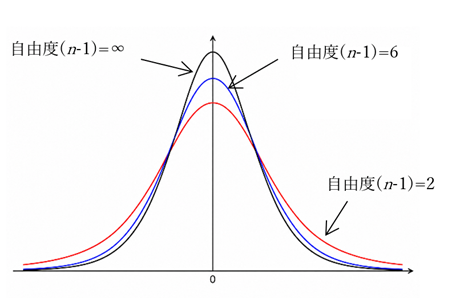
ただし、標本数が少ないときは、正規分布よりも裾が厚い形になります。
ユキさん裾が厚いというのは、平均から大きく離れた値が出る可能性を、
正規分布より少し大きく見ているということですか?
マナブ先生その通りです。
母標準偏差 \(\sigma\) が分からず、標本から求めた \(s\) を使っているので、その不確かさの分だけ慎重に考えているわけです。
ユキさんだから、95%信頼区間も少し広くなるんですね。
マナブ先生そうです。
ところで、\(t\)分布には標準正規分布との大きな違いがあります。
標準正規分布は一つだけですが、
\(t\)分布は一つではありません。
ユキさん何によって形が変わるんですか?
マナブ先生自由度です。
標本数が \(n\) 個なら、今回使う自由度は、
$$ \nu=n-1 $$
です。
ユキさんまた \(n-1\) が出てきましたね。
前回の不偏分散と同じですね。
マナブ先生そうです。
標本標準偏差 \(s\) を計算するときに、標本平均 \(\bar{x}\) を使っていますから、自由度は \(n-1\) になります。
自由度が小さい\(t\)分布は裾が厚く、自由度が大きくなるにつれて標準正規分布に近づいていきます。
自由度\(n-1\)の値が、2、6、∞の場合のグラフを見せます。
 ユキさん
つまり、標本数が増えるほど \(s\) も母標準偏差 \(\sigma\) を安定して推定できるようになるので、正規分布に近づくんですね。
マナブ先生その理解でいいですね。
標本数\(n\)が30以上になると、
\(t\)分布は正規分布とほぼ同じ形になります。
 ユキさん
でも、これだと正規分布表のようなものが
自由度の数だけ必要になってしまうのでしょうか?
マナブ先生そうなんです。
でも、実際に使う場面では
中心から\(t\)だけ離れた個所から外側の両すその面積、
つまり確率が0.1や0.05になる時の値が分かればいいケースがほとんどですので、それだけを抜き出した表が準備されています。
マナブ先生この表は縦が自由度\(n-1\)になっています。
それぞれの自由度に対して、確率が0.1、0.05、0.025、0.02、0.01、0.005の場合の\(t\)の値が示されています。
少し余談ですが、\(t\)分布を実用的に研究した人物として有名なのが、
ウィリアム・シーリー・ゴセットです。
彼はイギリスのギネス社で働いていた技術者でした。
ユキさんあの黒ビールのギネスですか?
マナブ先生そうです。
ビール製造では、原料や製造条件を評価したくても、
いつでも大量のデータを取れるわけではありません。
そこで、少ない標本からどこまで信頼できる判断ができるか
が重要でした。
ゴセットは論文を発表するときにStudentという筆名を使ったため、
「Studentの\(t\)分布」
と呼ばれるようになりました。
ユキさん品質管理のような実務上の問題から生まれた分布なんですね。
マナブ先生そう考えると、少し身近に感じますね。
\(t\)分布表を見てみよう
マナブ先生では、実際に\(t\)分布表を使ってみましょう。
標本数を、
$$ n=10 $$
とします。
自由度はいくつですか?
ユキさん$$ 10-1=9 $$
なので、自由度9です。
マナブ先生95%信頼区間を作るなら、中央に95%を残します。
外側には全部で何%残りますか?
ユキさん5%です。
左右対称なので、片側は2.5%ずつですね。
マナブ先生そうです。
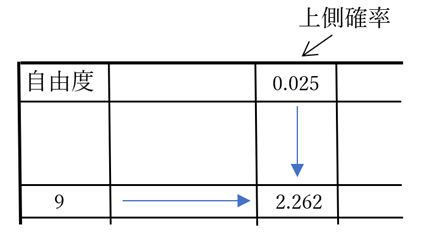
では、自由度9の\(t\)分布で、
上側2.5%
になる\(t\)値を表から探してみましょう。
ユキさん自由度9の行と、上側確率0.025の列を見ると……
$$ 2.262 $$
です。
 マナブ先生
そうですね。
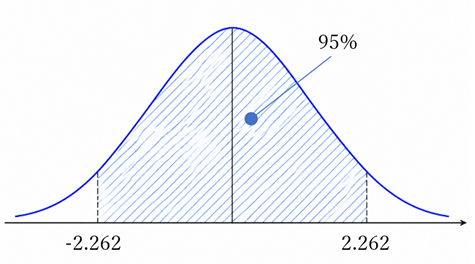
したがって、
$$ -2.262\le t\le2.262 $$
の中央部分が95%になります。
 ユキさん
標準正規分布なら1.96だったのに、\(t\)分布では2.262なんですね。
 マナブ先生
この違いは何を意味していると思いますか?
ユキさん\(t\)分布の方が裾が厚いので、
95%を中央に入れるには、
より遠いところまで取らないといけない。
だから信頼区間が広くなるんですね。
マナブ先生その通りです。
ユキさん\(t\)分布表も、今ならExcelで計算できますよね。
マナブ先生もちろんです。
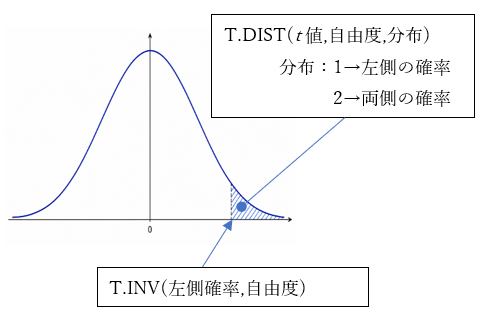
Excelでは、主に次の関数を使います。
| 内容 | 関数名 |
|---|---|
| \(t\)値・自由度→(左側)確率を求める | T.DIST(t,自由度,分布の指定) 分布の指定:1→左側の確率 2→両側の確率 |
| \(t\)値・自由度→右側確率を求める | T.DIST.RT(t,自由度) |
| \(t\)値・自由度→両側確率を求める | T.DIST.2T(t,自由度) |
| 左側確率・自由度→\(t\)値を求める | T.INV(左側確率,自由度) |
| 両側確率・自由度→\(t\)値を求める | T.INV.2T(両側確率,自由度) |
 マナブ先生
例えば、自由度9で両側5%に対応する\(t\)値なら、
T.INV.2T(0.05,9)
とすれば、
$$ 2.262\ldots $$
が得られます。
ユキさん関数名を見るだけでなんとなくわかりますね。
マナブ先生そうですね。
ただしExcelを使うときも、
片側確率なのか、両側確率なのか
を意識することが大切です。
母分散が未知の場合の母平均の信頼区間
マナブ先生では、一般的な形にまとめましょう。
母集団が正規分布に従い、母標準偏差 \(\sigma\) が未知であるとします。
標本数 \(n\)、標本平均 \(\bar{x}\)、標本標準偏差 \(s\) が得られたとき、
まず標準化した統計量として、
$$ t= \frac{\bar{x}-\mu} {s/\sqrt{n}} $$
を考えます。
この \(t\) は、自由度
$$ n-1 $$ の\(t\)分布に従います。
ユキさん前回の、
$$ z= \frac{\bar{x}-\mu} {\sigma/\sqrt{n}} $$
とほとんど同じですね。
マナブ先生そうです。
違うのは、
$$ \sigma $$
が分からないので、
$$ s $$
を使っているところです。
その結果、標準正規分布ではなく\(t\)分布を使います。
母標準偏差が未知の場合の95%信頼区間
自由度を、
$$ \nu=n-1 $$
とすると、母平均 \(\mu\) の95%信頼区間は、
$$ \bar{x} \pm t_{0.025,\nu} \frac{s}{\sqrt{n}} $$
です。
ここで、
$$ t_{0.025,\nu} $$
は、自由度 \(\nu\) の\(t\)分布で上側2.5%となる値です。
ユキさん標準正規分布の1.96が、
\(t\)分布の値に置き換わっただけなんですね。
マナブ先生そう考えると、とても分かりやすいですね。
実際の品質データで計算してみよう
マナブ先生では、品質管理らしい例で計算してみましょう。
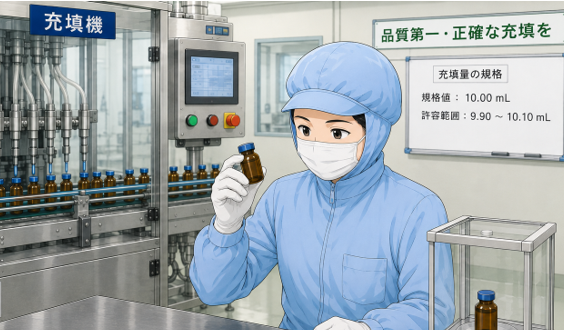
ある製薬工場で、薬液を瓶に充填しています。
充填量は正規分布に従うものとします。
ただし、母標準偏差は分かっていません。
製造ラインから無作為に10本を取り出して測定したところ、次のデータが得られました。
単位はmLです。
$$ 99.2,\ 100.5,\ 98.8,\ 101.1,\ 99.7, $$ $$ 100.3,\ 99.5,\ 100.8,\ 98.9,\ 101.2 $$
このデータから、母平均 \(\mu\) の95%信頼区間を求めてみましょう。
 マナブ先生
10個ですから、今回は手計算してみましょうか。
まず、何を求めますか?
ユキさん標本平均 \(\bar{x}\) と、標本標準偏差 \(s\) ですね。
① 標本平均を求める
ユキさんまず標本平均です。
全部足すと、
$$ 1000.0 $$
ですから、
$$ \bar{x} = \frac{1000.0}{10} = 100.0\ \mathrm{mL} $$
です。
きれいに100 mLになりましたね。
マナブ先生計算しやすい例にしました(笑)。
② 偏差平方和を求める
マナブ先生では、それぞれ100.0からどのくらい離れているかを見てみましょう。
ユキさん偏差は、
$$ -0.8,\ 0.5,\ -1.2,\ 1.1,\ -0.3, $$ $$ 0.3,\ -0.5,\ 0.8,\ -1.1,\ 1.2 $$
ですね。
これを二乗すると、
$$ 0.64,\ 0.25,\ 1.44,\ 1.21,\ 0.09, $$ $$ 0.09,\ 0.25,\ 0.64,\ 1.21,\ 1.44 $$
です。
全部足すと、
$$ 7.26 $$
になります。
マナブ先生これが偏差平方和ですね。
③ 不偏分散と標本標準偏差
ユキさん標本から母分散を推定するので、\(n\) ではなく \(n-1\) で割ります。
$$ s^2 = \frac{7.26}{10-1} = \frac{7.26}{9} \approx0.8067 $$
したがって、
$$ s = \sqrt{0.8067} \approx0.898 \ \mathrm{mL} $$
です。
マナブ先生いいですね。
では標準誤差は?
ユキさん$$ \frac{s}{\sqrt{n}} = \frac{0.898}{\sqrt{10}} $$
なので、
$$ \approx0.284\ \mathrm{mL} $$
です。
④ \(t\)値を求める
マナブ先生標本数は10ですから自由度は?
ユキさん$$ \nu=10-1=9 $$
です。
95%信頼区間なので、上側2.5%の\(t\)値は、
$$ t_{0.025,9}=2.262 $$
ですね。
⑤ 95%信頼区間を求める
ユキさんでは公式、
$$ \bar{x} \pm t_{0.025,9} \frac{s}{\sqrt{n}} $$
に代入します。
$$ 100.0 \pm 2.262 \times \frac{0.898}{\sqrt{10}} $$
なので、
$$ 100.0\pm0.642 $$
くらいですね。
したがって、
$$ 99.36\ \mathrm{mL} \le \mu \le 100.64\ \mathrm{mL} $$
となります。
マナブ先生よくできました。
マナブ先生さて、計算は終わりました。
でも統計解析では、ここからが大切です。
この、
$$ 99.36\le\mu\le100.64 $$
は何を意味しているのでしょう?
ユキさん母平均が95%の確率でこの間にある……
と言いたくなりますけど、前回それは少し違うと習いましたね。
マナブ先生そうでしたね。
正確には、
同じ方法で10本を抽出して95%信頼区間を作る作業を
何度も繰り返せば、その区間の約95%が真の母平均を含む
という意味です。
ユキさんそうでした。
そして今回の標本から作った信頼区間が、
$$ 99.36\sim100.64\ \mathrm{mL} $$
ということですね。
正規分布の場合と\(t\)分布の場合を比べてみよう
マナブ先生では、もし母標準偏差が本当に、
$$ \sigma=0.898 $$
と分かっていたと仮定したら、
前回の方法では何を使いますか?
ユキさん1.96です。
マナブ先生今回は母標準偏差が未知なので?
ユキさん
ユキさん自由度9の\(t\)値、
$$ 2.262 $$
です。
マナブ先生どちらが大きいですか?
ユキさん2.262です。
だから母標準偏差が分からない方が信頼区間は少し広くなります。
マナブ先生なぜでしたか?
ユキさん\(\sigma\) の代わりに標本から求めた \(s\) を使うため、その分の不確かさも考慮する必要があるからです。
マナブ先生完璧です。
ユキさん標本数\(n\)が30以上になると、
\(t\)分布は正規分布とほぼ同じ形になるということでしたが、
そうすると、
「標本数が30未満なら\(t\)分布、30以上なら正規分布」
と覚えておけばいいですか?
マナブ先生よく聞く目安ですが、それを絶対的なルールとして覚えない方がいいでしょう。
本質は標本数30ではありません。
母標準偏差 \(\sigma\) が未知で、
それを標本標準偏差 \(s\) で置き換える場合に\(t\)分布が登場します。
そして自由度が大きくなれば、
\(t\)分布そのものが標準正規分布に非常に近づいていきます。
ユキさんつまり、標本が多いから「急に別の方法になる」のではなくて、
標本が増えるにつれて\(t\)分布が
だんだん正規分布に近づいているんですね。
マナブ先生そう理解する方が正確です。
今日の内容を整理してみよう
マナブ先生ではユキさん、前回と今回の違いを整理してみてください。
ユキさん母標準偏差 \(\sigma\) が既知なら、
$$ z= \frac{\bar{x}-\mu}{\sigma/\sqrt{n}} $$
を使って標準正規分布で考えます。
母標準偏差 \(\sigma\) が未知なら、標本から求めた \(s\) を使って、
$$ t= \frac{\bar{x}-\mu}{s/\sqrt{n}} $$
とし、自由度 \(n-1\) の\(t\)分布を使います。
マナブ先生いいですね。
信頼区間は?
ユキさん母標準偏差が既知なら、
$$ \bar{x} \pm 1.96 \frac{\sigma}{\sqrt{n}} $$
母標準偏差が未知なら、
$$ \bar{x} \pm t_{0.025,n-1} \frac{s}{\sqrt{n}} $$
です。
マナブ先生そして、なぜ\(t\)分布の方が裾が厚いのでしょう?
ユキさん母標準偏差 \(\sigma\) の代わりに、
標本によって変動する \(s\) を使っているから。
その追加の不確かさを考慮しているからですね。
マナブ先生その理解ができていれば、
式を丸暗記しなくても大丈夫です。
今回のポイント
母標準偏差 \(\sigma\) が未知の場合は、標本から求めた標準偏差 \(s\) を使います。
このとき、
$$ t= \frac{\bar{x}-\mu}{s/\sqrt{n}} $$
は自由度、
$$ n-1 $$
の\(t\)分布に従います。
したがって、母平均 \(\mu\) の95%信頼区間は、
$$ \bar{x} \pm t_{0.025,n-1} \frac{s}{\sqrt{n}} $$
となります。
\(t\)分布は標準正規分布に似ていますが、自由度が小さいほど裾が厚くなります。
これは、
母標準偏差 \(\sigma\) が分からず、標本から推定した \(s\) を使うことによる追加の不確かさ
を反映しています。
そして自由度が大きくなると、\(t\)分布は標準正規分布に近づいていきます。
重要なのは、
「\(n\)が30未満だから\(t\)分布」
と機械的に覚えることではなく、
母標準偏差が分からないため、標本標準偏差で推定している。
その不確かさを\(t\)分布で考慮している。
と理解することです。
あなたも考えてみましょう
今回の10本の充填量では、
$$ \bar{x}=100.0\ \mathrm{mL} $$ $$ s\approx0.898\ \mathrm{mL} $$
でした。
もし標本数を10本から40本に増やし、標本平均と標本標準偏差がほぼ同じだったとします。
そのとき、
95%信頼区間は広くなるでしょうか、狭くなるでしょうか?
考えるポイントは二つです。
一つは、
$$ \frac{s}{\sqrt{n}} $$
という標準誤差。
もう一つは、自由度が増えるにつれて\(t\)値が1.96に近づくことです。
どちらも、標本数が増えると信頼区間を狭くする方向に働きます。
つまり、
より多くの標本を集めることで、
母平均をより精度よく推定できる ということです。
次回
次回は、
4-4.なぜ標本平均は正規分布に近づくのか
― 中心極限定理 ―
です。
非常に重要な考え方である中心極限定理について学びます。
シリーズ全体の目次
『品質をデータで読み解く 統計解析・データサイエンス入門』
― 品質管理の現場で使える「見る・推定する・判断する」ための統計学 ―
全体の目次はここをご覧ください。