母集団が正規分布でない場合
 ユキさん
マナブ先生、少し気になっていたことがあります。
これまで母平均の推定をするとき、
「母集団が正規分布に従っている」
という条件がよく出てきましたよね。
でも、前にヒストグラムを勉強したとき、
実際のデータは必ずしも左右対称ではないという話もありました。
母集団が正規分布ではない場合は、どうするんでしょうか?
 マナブ先生
いいところに気づきましたね。
実際には、母集団が正規分布ではないことは珍しくありません。
例えば、故障までの時間、待ち時間、所得、ある種の不良数などは、
左右対称の正規分布とはかなり違う形になることがあります。
では、母集団が正規分布でなければ、
これまで勉強した平均値の推定はすべて使えなくなるのでしょうか?
 ユキさん
それだと困りますね。
実際のデータが全部きれいな正規分布になるとは思えませんし……。
マナブ先生そうですよね。
そこで、統計学の非常に重要な考え方が登場します。
「中心極限定理(central limit theorem)」
です。
ただ、名前だけ聞いても分かりにくいので、まず具体的に考えてみましょう。
1個の測定値と「平均値」は違う
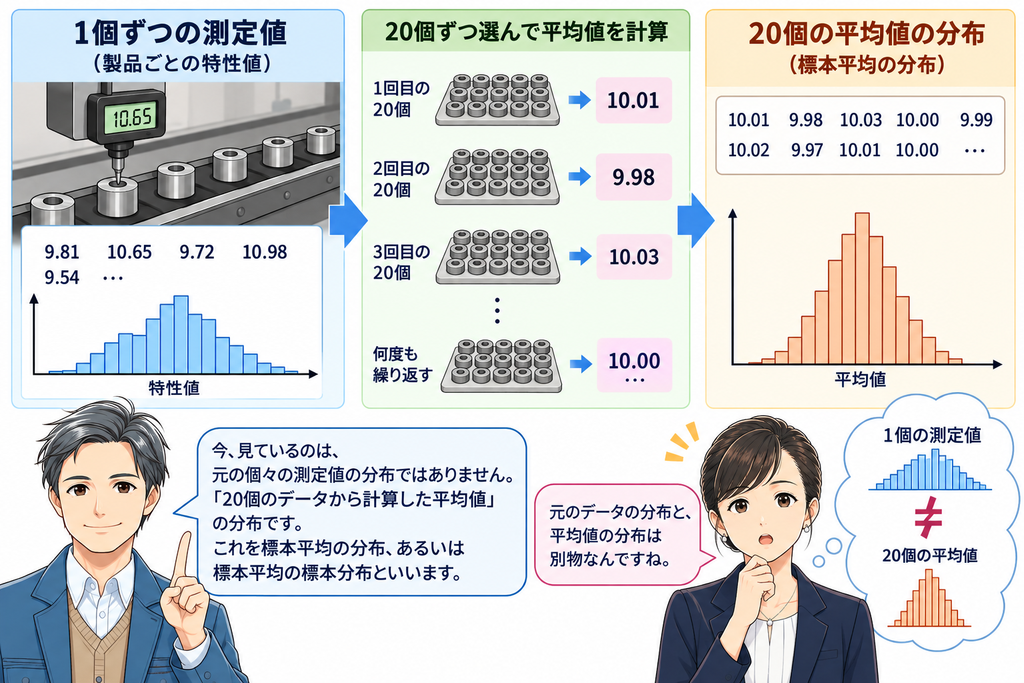
マナブ先生ある製造ラインで、部品のある特性値を測定しているとします。
1個ずつ測定すると、
$$ 9.81,\quad10.65,\quad9.72,\quad10.98,\quad9.54,\ldots $$
のように、値にはかなりばらつきがあったとします。
では、ここから20個を選んで平均値を計算するとしましょう。
例えば最初の20個の平均が、
$$ 10.01 $$
だったとします。
別の20個を選んだら、
$$ 9.98 $$
さらに別の20個なら、
$$ 10.03 $$
だったとします。
この操作を何度も繰り返したら、何ができますか?
ユキさん20個ずつの平均値がたくさんできますね。
例えば、
$$ 10.01,\quad9.98,\quad10.03,\quad10.00,\quad9.99,\ldots $$
というように。
マナブ先生そうです。
ここがとても重要です。
今見ているのは、元の個々の測定値の分布ではありません。
「20個のデータから計算した平均値」の分布
です。
これを標本平均の分布、あるいは標本平均の標本分布といいます。
ユキさん元のデータの分布と、平均値の分布は別物なんですね。
マナブ先生その通りです。
ここを区別できるかどうかが、中心極限定理を理解するポイントです。
元のデータが偏っていたら?
マナブ先生では、もう少し極端に考えてみましょう。
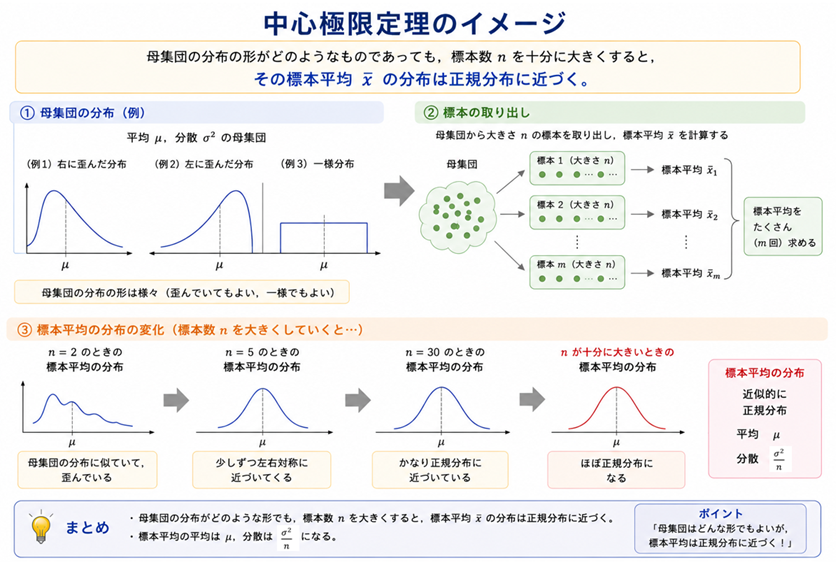
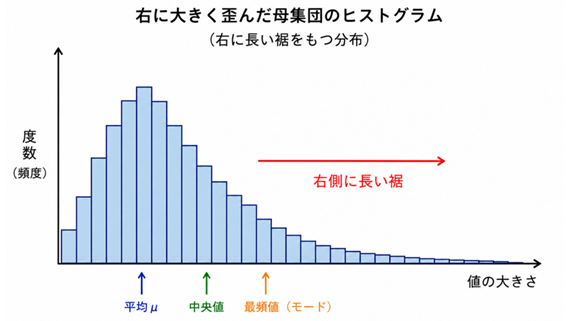
元の母集団が、こんな左右非対称の分布だったとします。
 マナブ先生
右側に長い裾があり、正規分布とはかなり違いますね。
この母集団から、まず1個だけ取り出すことを何度も繰り返したら、
その値の分布はどうなりますか?
ユキさん元の母集団と同じような形になりますよね。
マナブ先生そうです。
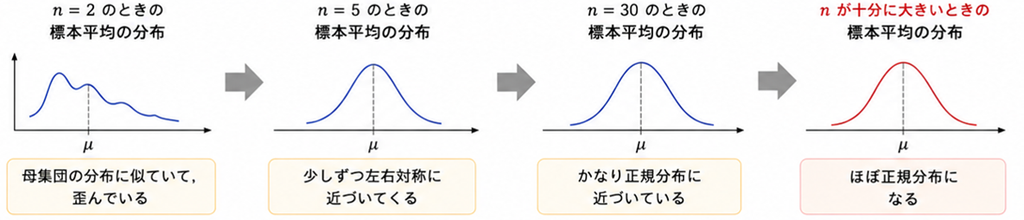
では、毎回2個取り出して平均を計算し、
その平均値をたくさん集めたら?
ユキさん元の形よりは、少し真ん中に集まってきそうです。
マナブ先生では10個の平均なら?
ユキさんもっと中心に集まりそうです。
マナブ先生30個、50個……と増やしていったら?
 ユキさん
だんだん左右対称の山型に近づいていく……。
あっ、これが正規分布に近づくということですか?
マナブ先生その通りです。
 マナブ先生
これが中心極限定理の最も重要なイメージです。
中心極限定理
マナブ先生一般的には、次のように考えます。
平均が、
$$ \mu $$
分散が、
$$ \sigma^2 $$
である母集団から、互いに独立に大きさ \(n\) の標本を取り、
その標本平均を
$$ \bar{X} $$
とします。
すると、標本平均の平均は、
$$ E(\bar{X})=\mu $$
になります。
そして標本平均の分散\(Var(\bar{X})\)は、
$$ Var(\bar{X}) = \frac{\sigma^2}{n} $$
標準偏差\(SD(\bar{X})\)、つまり標準誤差は、
$$ SD(\bar{X}) = \frac{\sigma}{\sqrt{n}} $$
になります。
さらに、一定の条件のもとで、\(n\) が十分大きくなると、
$$ \bar{X} $$
の分布は正規分布に近づいていきます。
平均 \(\mu\)、分散 \(\sigma^2\) を持つ母集団から、独立に大きさ \(n\) の標本を取り出す。
その標本平均を \(\bar{X}\) とすると、
$$ E(\bar{X})=\mu $$
$$ Var(\bar{X}) = \frac{\sigma^2}{n} $$
したがって、
$$ SD(\bar{X}) = \frac{\sigma}{\sqrt{n}} $$
となる。
さらに、一定の条件のもとで \(n\) が十分大きければ、母集団が正規分布でなくても、
$$ \bar{X} \approx N \left( \mu,\frac{\sigma^2}{n} \right) $$ と近似できる。
母集団が正規分布なら、もっと強い
マナブ先生ここで、二つの場合を分けて考えると整理しやすいですよ。
まず、母集団そのものが正規分布、
$$ X\sim N(\mu,\sigma^2) $$
だったら、標本平均 \(\bar{X}\) はどうなると思いますか?
ユキさん標本数が十分大きければ正規分布になる、でしょうか?
マナブ先生実は、この場合はもっと強いことが言えます。
母集団が正規分布なら、
標本数 \(n\) が小さくても、標本平均は正規分布に従います。
つまり、
$$ \bar{X} \sim N \left( \mu,\frac{\sigma^2}{n} \right) $$
が成り立ちます。
ユキさんでは、中心極限定理が特にありがたいのは、
母集団が正規分布ではないときなんですね。
マナブ先生そう考えるとよいでしょう。
母集団が正規分布でなくても、
標本数を十分大きくすると、標本平均の分布を正規分布で近似できる。
これが非常に強力なのです。
なぜ平均すると正規分布に近づくの?
ユキさんでも、不思議ですね。
元の分布が正規分布でないのに、
どうして平均を取ると正規分布に近づくのでしょう?
マナブ先生直感的には、
平均を取ることで、一つ一つの極端な値の影響が薄められる
と考えるとよいでしょう。
例えば1個だけ測れば、たまたま非常に大きな値を引くことがあります。
でも20個の平均なら、その1個が少し大きくても、
ほかの19個と平均されます。
ユキさんだから平均値は、元のデータより真ん中付近に集まりやすいんですね。
マナブ先生そうです。
しかも標本数が増えるほど、
$$ \frac{\sigma}{\sqrt{n}} $$
が小さくなるので、標本平均の分布そのものも細くなっていきます。
例えば母標準偏差が、
$$ \sigma=10 $$
なら、
\(n=1\) では標準誤差は、
$$ 10 $$
\(n=4\) では、
$$ \frac{10}{\sqrt4}=5 $$
\(n=25\) なら、
$$ \frac{10}{\sqrt{25}}=2 $$
です。
ユキさんつまり標本数を増やすと、
形は正規分布に近づき、しかも幅も狭くなる
ということですね。
マナブ先生非常にいい整理です。
この二つは別の話なので、区別してください。
一つは、
標本平均の分布の形が正規分布に近づく。
もう一つは、
標準誤差 \(\sigma/\sqrt{n}\) が小さくなり、
標本平均が母平均の周囲に集中する。
です。
ユキさんたくさん平均すると中心に集まるから、
「中心極限定理」という名前なんでしょうか?
マナブ先生そうイメージすると覚えやすいかもしれませんね。
ただし、名前の由来をそこだけで理解する必要はありません。
大切なのは、
さまざまな分布から得られる和や平均が、条件のもとで正規分布という共通の形に近づいていく
という性質です。
「n≧30なら大丈夫」なの?
マナブ先生一つ注意があり、
「標本数が30以上なら正規分布と考えてよい」
と聞くことがあると思います。
これは非常によく使われる目安ですが、
「30以上なら必ず大丈夫」
という定理ではありません。
ユキさんまた30は絶対的な境界ではないんですね。
マナブ先生そうです。
必要な標本数は、元の母集団の形によって変わります。
例えば母集団がすでに正規分布に近ければ、
少ない標本でも標本平均の分布はかなり正規分布に近くなります。
一方、
母集団が強く歪んでいたり、
極端な外れ値が多かったりすると、
30個でも十分でない場合があります。
ユキさんでは、
「30だからOK」
ではなく、
元のデータがどんな分布なのかも見る
必要があるんですね。
マナブ先生そうです。
だから前に学んだヒストグラムが、ここでも重要になります。
こんなデータには注意
マナブ先生さらに、中心極限定理を使うときにも条件があります。
例えば製造データが、
午前中に測った値が次の値に強く影響する、
同じロット内のデータ同士が強く関係している、
という場合はどうでしょう?
ユキさんデータ同士が独立ではないですね。
マナブ先生そうです。
教科書で最初に学ぶ中心極限定理では、基本的に、
同じ母集団から独立に標本を取る
ことを前提に考えます。
また、極端に裾の重い分布などでは、単純な適用に注意が必要です。
したがって、
「データが30個あれば何でも正規分布にしてよい」
というわけではありません。
品質管理ではどう考える?
ユキさん品質管理では、中心極限定理はどんなところで役立つんですか?
マナブ先生例えば、ある製造工程から5個ずつ製品を取って、
$$ \bar{x} $$
を計算するとしましょう。
それを毎時間繰り返します。
ユキさん毎時間、「5個の平均値」が一つずつできますね。
マナブ先生そうです。
品質管理でよく使う\(\bar{X}\)管理図では、
まさに標本平均を扱います。
個々の製品にはある程度のばらつきがあっても、
標本平均のばらつきは、
$$ \frac{\sigma}{\sqrt{n}} $$
と小さくなります。
標本平均の性質を理解することが、
工程の変化を見つける考え方につながっていきます。
ユキさん中心極限定理は、単なる数学の定理ではなく、
品質管理そのものにもつながっているんですね。
 マナブ先生
そうです。
そして推定や検定でも同じです。
私たちは母集団全体を見ることはできません。
でも標本平均がどのようにばらつくのかが分かれば、
手元の標本平均から母平均について判断できる
ようになります。
データサイエンスでも重要?
ユキさんデータサイエンスやAIでも
中心極限定理は関係するのでしょうか?
マナブ先生もちろんです。
例えばAIモデルの性能を評価するとき、
一度だけ計算した平均精度を見るのではなく、
データを取り直したり分割し直したりして、
平均的にどのくらいの性能になるのか
を評価することがあります。
また、A/Bテストや実験結果の比較、平均値の信頼区間など、
多くの統計的判断の背景に標本平均の分布があります。
ユキさんデータが大量になっても、
「平均値がどのくらいばらつくのか」
という考え方は必要なんですね。
マナブ先生そうです。
ただしAIでも同じ注意があります。
100万件のデータがあっても、それらが
強く偏っていたり、
独立でなかったりすれば、
「データ数が大きいから大丈夫」
とは言えません。
統計ではいつも、
どんなデータから、どのように標本を取ったのか
を考える必要があります。
今日の内容を整理してみよう
マナブ先生ではユキさん、中心極限定理を自分の言葉で説明してみてください。
ユキさんはい。
母集団から同じ大きさ \(n\) の標本を何度も取り、そのたびに平均値を計算します。
その標本平均をたくさん集めて分布を見ると、
母集団が正規分布でなくても、一定の条件のもとで \(n\) を十分大きくすると、
標本平均の分布が正規分布に近づいていく。
これが中心極限定理です。
マナブ先生いいですね。
標本平均の平均は?
ユキさん母平均と同じ、
$$ \mu $$
です。
マナブ先生標準偏差は?
ユキさん$$ \frac{\sigma}{\sqrt{n}} $$
です。
これは標準誤差ですね。
マナブ先生では、標本数を増やすと?
ユキさん標本平均の分布は正規分布に近づき、
さらに標準誤差が小さくなるので、
標本平均は母平均の近くにより集中するようになります。
マナブ先生十分です。
では最後に、一番注意したいことは?
ユキさん「元のデータそのものが正規分布になるわけではない」
ということですね。
正規分布に近づくのは、
標本平均の分布です。
マナブ先生そこが一番大切です。
今回のポイント
「中心極限定理」は、統計学で最も重要な定理の一つです。
平均 \(\mu\)、分散 \(\sigma^2\) を持つ母集団から、
大きさ \(n\) の標本を独立に取り出し、その標本平均を \(\bar{X}\) とすると、
$$ E(\bar{X})=\mu $$
$$ Var(\bar{X}) = \frac{\sigma^2}{n} $$
$$ SD(\bar{X}) = \frac{\sigma}{\sqrt{n}} $$
となります。
母集団が正規分布なら、標本平均は標本数によらず正規分布に従います。
一方、母集団が正規分布でなくても、一定の条件のもとで標本数 \(n\) を十分大きくすると、
$$ \bar{X} \approx N \left( \mu,\frac{\sigma^2}{n} \right) $$
と近似できるようになります。
重要なのは、
正規分布に近づくのは「元のデータ」ではなく、「標本平均の分布」である。
という点です。
また、
「\(n\ge30\)なら必ず正規分布とみなせる」わけではありません。
必要な標本数は元の母集団の形や外れ値の有無、データ間の依存関係などによって変わります。
あなたも考えてみましょう
ある工程の製品データは、右側に長い裾を持つ分布になっていました。
この母集団の平均を、
$$ \mu=100 $$
標準偏差を、
$$ \sigma=12 $$
とします。
ここから、
$$ n=36 $$
個ずつ標本を取り、毎回平均値を計算するとします。
標本平均の平均は、
$$ \mu_{\bar{X}}=100 $$
です。
では、標本平均の標準誤差はいくつでしょう?
$$ \frac{\sigma}{\sqrt{n}} = \frac{12}{\sqrt{36}} = 2 $$
ですね。
つまり、個々のデータは標準偏差12と大きくばらついていても、
36個の平均値は、標準偏差2というずっと狭い範囲に集まります。
そして母集団そのものが正規分布でなくても、条件が満たされ標本数が十分なら、その標本平均の分布は正規分布に近づいていきます。
これが、
「平均を取るとなぜ安定するのか」 を統計学的に説明しているのです。
次回
次回は、
4-5.「合格・不合格」を確率で考える
― 二項分布
です。
2通りの結果がある試行を、同じ条件で繰り返した時に、
ある事柄が起こる確率を表す二項分布について学びます。
シリーズ全体の目次
『品質をデータで読み解く 統計解析・データサイエンス入門』
― 品質管理の現場で使える「見る・推定する・判断する」ための統計学 ―
全体の目次はここをご覧ください。