標本から母集団全体の割合を推定
 マナブ先生
ユキさん、
「内閣支持率が55%でした」
「この商品を支持する人は40%でした」
というニュースを聞くことがありますね。
この55%や40%は、全国民やすべての消費者に聞いて求めているのでしょうか?
 ユキさん
そんなことはないですよね。
何人かを選んでアンケートをして、
その結果から全体を推測しているのだと思います。
マナブ先生そうですね。
例えば全国から1,000人程度を抽出して、
そのうち550人が「支持する」と答えたら、
$$ \frac{550}{1000}=0.55 $$
つまり55%です。
でも、本当に国民全体の支持率がぴったり55%だと言えるでしょうか?
ユキさん言い切れないと思います。
別の1,000人に聞いたら、53%になったり57%になったりするかもしれません。
マナブ先生その通りです。
これは、前に学んだ標本平均と同じ考え方なんです。
標本平均にばらつきがあったように、
標本から求めた「割合」にもばらつきがあります。
今日は、そのばらつきを利用して、母集団全体の割合を推定してみましょう。
母比率と標本比率
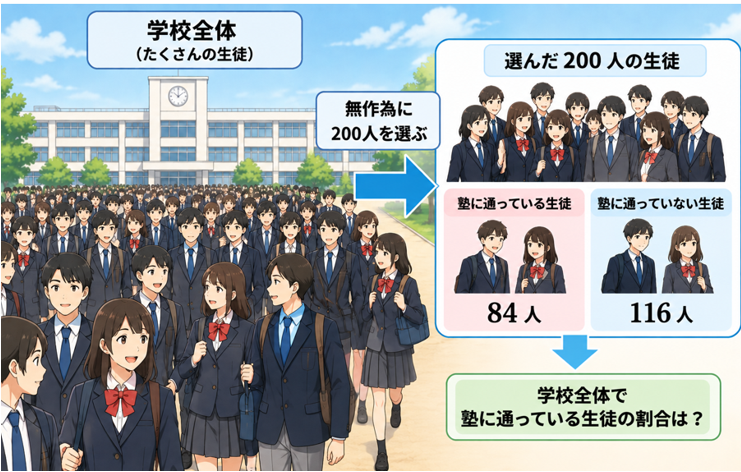
マナブ先生ある学校にたくさんの生徒がいるとします。
学校全体で、
「塾に通っている生徒の割合」
を知りたいとしましょう。
ただし、全員を調べるのは大変なので、無作為に200人を選びました。
結果は、
塾に通っている生徒:84人
塾に通っていない生徒:116人
でした。
まず、この200人の中で塾に通っている生徒の割合はいくつですか?
 ユキさん
$$ \frac{84}{200}=0.42 $$
なので、
$$ 42\% $$
です。
マナブ先生このように標本から得られた割合を標本比率といいます。
通常、
$$ \hat p $$
と書きます。
したがって今回は、
$$ \hat p=0.42 $$
ですね。
一方、本当に知りたい学校全体の割合を何としましょう?
ユキさん\(p\) ですね。
マナブ先生そうです。
\(p\) が母比率です。
つまり今分かっているのは、
$$ \hat p=0.42 $$
で、本当に知りたいのは、
$$ p=? $$
ということです。
まずは点推定すると?
マナブ先生では、母比率 \(p\) を一つの値で推定するとしたら、
何を使うのが自然でしょう?
ユキさん標本比率の42%ですね。
つまり、
$$ \hat p=0.42 $$
を母比率の推定値にする。
マナブ先生その通りです。
これは前に勉強した点推定です。
でも先ほどユキさん自身が言ったように、
別の200人を選べば42%にはならないかもしれません。
では、今度は何を知りたくなりますか?
ユキさん本当の割合 \(p\) が、
どのくらいの範囲にありそうなのか
を知りたいです。
マナブ先生そうですね。
それが母比率の区間推定です。
「塾に通う・通わない」は何分布?
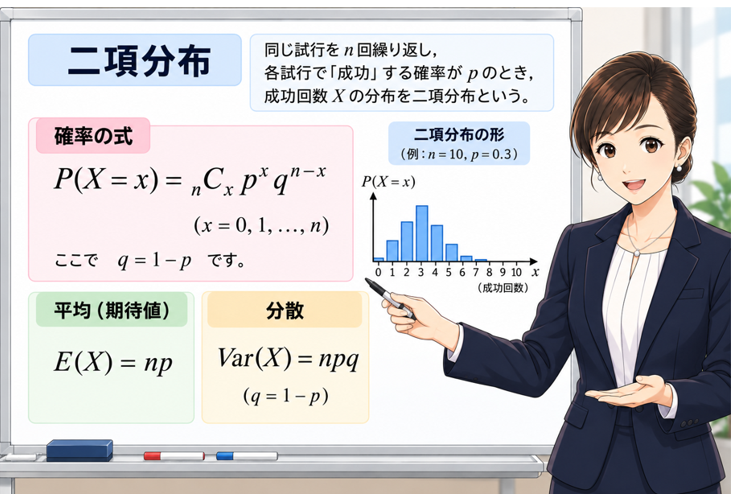
マナブ先生では、まず200人のうち84人が塾に通っていたという現象を、確率分布として考えてみましょう。
一人について見ると結果は?
ユキさん「塾に通っている」か「通っていない」の二つです。
マナブ先生このような試行を200回行い、
「塾に通っている」が何人になるかを考えます。
前回勉強した何分布でしょう?
 ユキさん
二項分布ですね。
マナブ先生その通りです。
塾に通っている人数を \(X\) とすれば、
$$ X\sim B(n,p) $$
です。
今回は、
$$ n=200 $$
ですね。
二項分布の平均と分散を覚えていますか?
ユキさんはい。
$$ E(X)=np $$
$$ Var(X)=np(1-p) $$
です。
人数ではなく「割合」にしたら?
マナブ先生でも今回は「何人か」ではなく、
「何%か」を知りたいんですよね。
標本比率 \(\hat p\) は、
人数 \(X\) を標本数 \(n\) で割った、
$$ \hat p=\frac{X}{n} $$
です。
では、\(\hat p\) の平均はどうなるでしょう?
ユキさん\(x\) の平均が \(np\) だから、
それを \(n\) で割って、
$$ E(\hat p)=p $$
ですね。
マナブ先生そうです。
つまり標本比率は、平均的には母比率 \(p\) を捉えています。
では分散は?
ユキさん\(x\) を \(n\) で割っているので、
分散は \(n^2\) で割るんでしたね。
だから、
$$ Var(\hat p) = \frac{np(1-p)}{n^2} $$
なので、
$$ Var(\hat p) = \frac{p(1-p)}{n} $$
ですね。
マナブ先生その通りです。
では標準偏差は?
ユキさん平方根を取って、
$$ \sqrt{\frac{p(1-p)}{n}} $$
です。
マナブ先生この値は、標本比率が標本を取り直すたびに
どのくらいばらつくかを表しています。
つまり、標本比率の標準誤差ですね。
 ユキさん
ここで一つ問題があります。
この式には、
$$ p $$
が入っていますよね。
でも、その \(p\) が分からないから推定しているのではないですか?
マナブ先生非常にいいところに気づきましたね。
では、どうすればよいと思いますか?
ユキさん今分かっている標本比率、
$$ \hat p $$
で代用するのでしょうか。
 マナブ先生
その通りです。
そこで標準誤差を、
$$ \sqrt{ \frac{\hat p(1-\hat p)}{n} } $$
と推定します。
今回なら、
$$ \hat p=0.42 $$
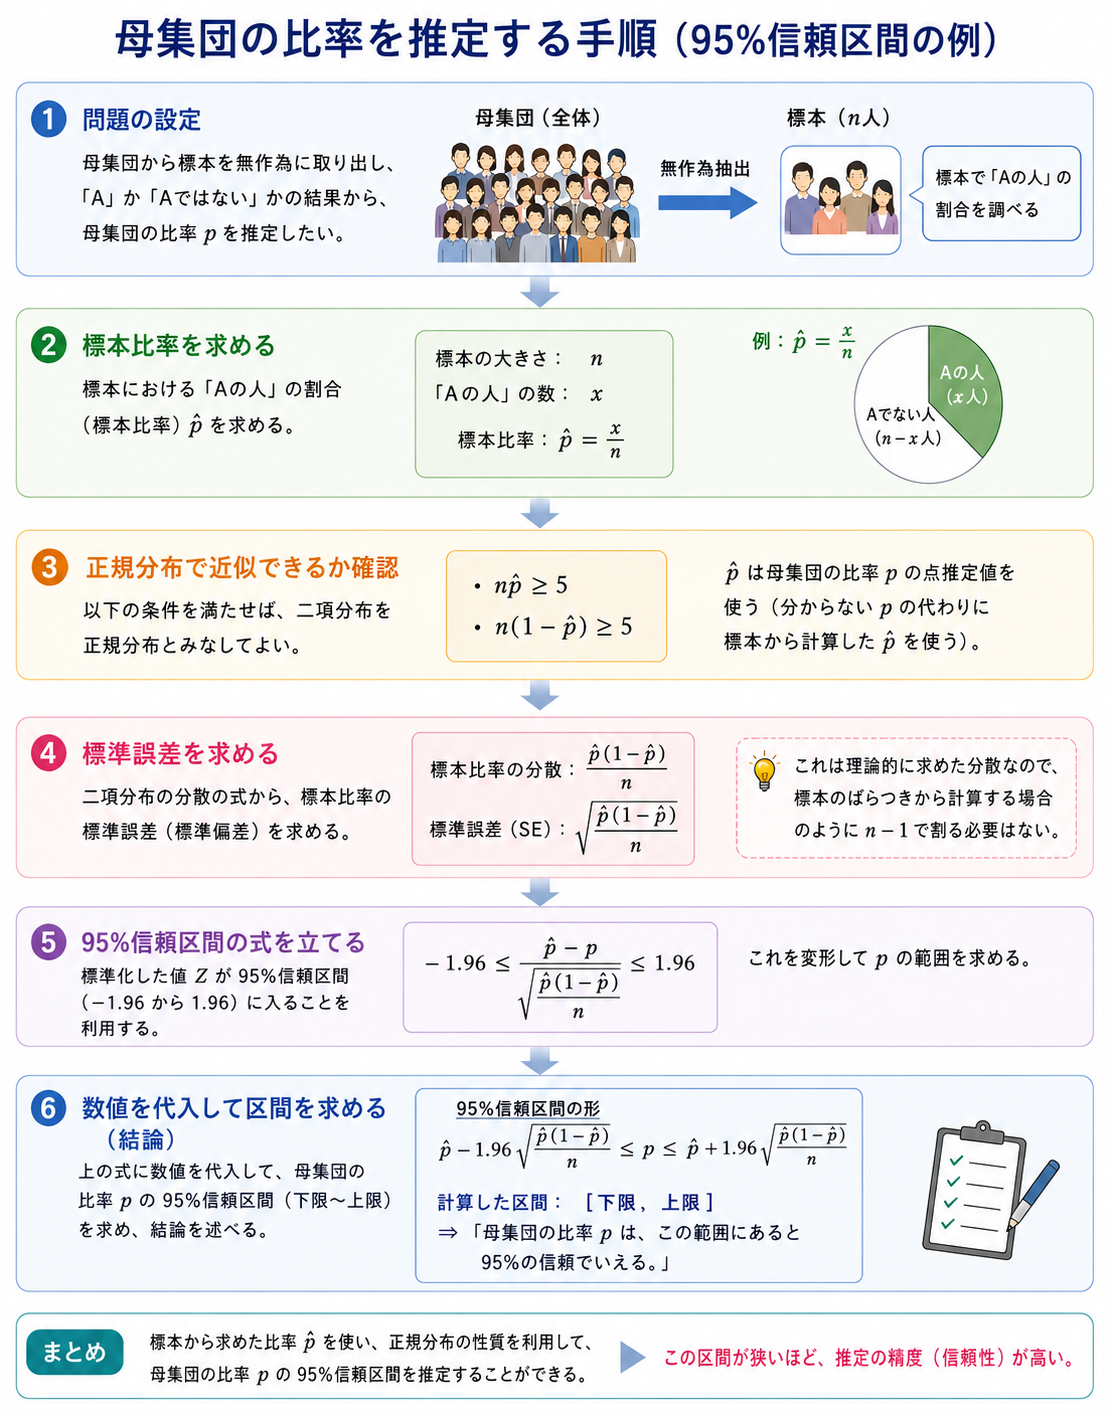
二項分布を正規分布で近似する
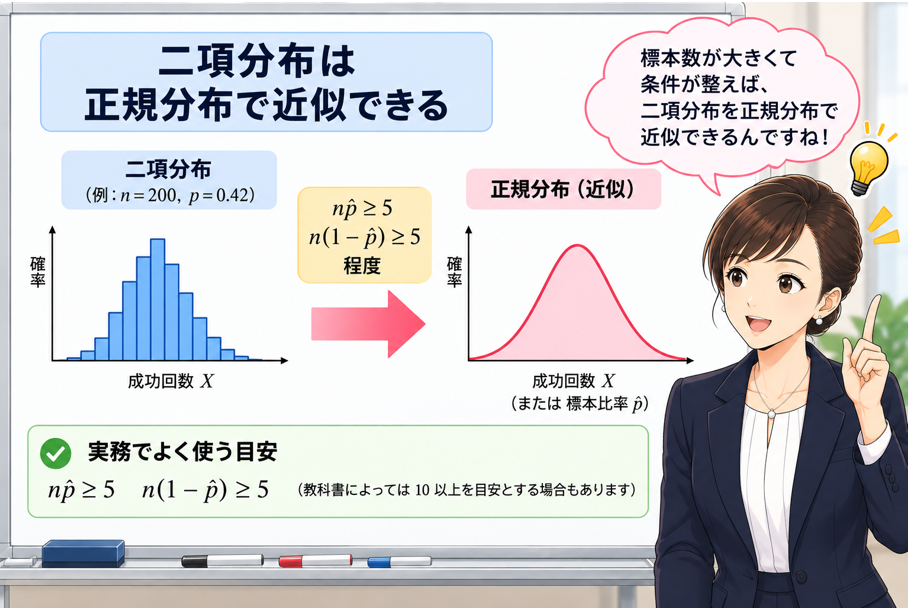
ユキさんでも、二項分布って必ずしも正規分布の形ではありませんよね。
前回、\(p\) が小さいとかなり歪むという話がありました。
マナブ先生そうでしたね。
では、標本数が大きくなると二項分布はどうなりましたか?
ユキさん条件が整えば、正規分布で近似できるようになります。
マナブ先生そうです。
実務でよく使う一つの目安として、
$$ n\hat p\ge5 $$ $$ n(1-\hat p)\ge5 $$
程度であることを確認します。
教科書によっては、より慎重に10以上を目安とする場合もあります。
では今回確認してみましょう。
ユキさん$$ n\hat p = 200\times0.42 = 84 $$
です。
そして、
$$ n(1-\hat p) = 200\times0.58 = 116 $$
です。
どちらも十分大きいですね。
マナブ先生そうですね。
したがって今回は、標本比率の分布を正規分布で近似して考えてみましょう。
95%信頼区間を作ってみる
マナブ先生標準正規分布の中央95%に対応する値は?
ユキさん$$ -1.96\le z\le1.96 $$
ですね。
マナブ先生では、標本比率 \(\hat p\) を標準化すると、概念的には、
$$ z = \frac{\hat p-p} {\sqrt{p(1-p)/n}} $$
となります。
実際に簡便な信頼区間を作るときには、
未知の \(p\) を標本比率 \(\hat p\) で置き換えます。
すると95%信頼区間は、
$$ \hat p \pm 1.96 \sqrt{ \frac{\hat p(1-\hat p)}{n} } $$
となります。
ユキさん前に勉強した母平均の95%信頼区間、
$$ \bar{x} \pm 1.96\times\text{標準誤差} $$
と同じ形ですね。
マナブ先生そこに気づくと、とても分かりやすくなります。
基本的には、
$$ \text{推定値} \pm 1.96\times\text{推定値の標準誤差} $$
という考え方なんです。
ではユキさん、今回の値を入れてみてください。
ユキさん標本比率は、
$$ \hat p=0.42 $$
です。
標準誤差は、
$$ \sqrt{ \frac{0.42\times0.58}{200} } $$
なので、
$$ \sqrt{0.001218} \approx0.0349 $$
です。
95%信頼区間の幅は、
$$ 1.96\times0.0349 \approx0.0684 $$
ですね。
したがって、
$$ 0.42-0.0684 = 0.3516 $$ $$ 0.42+0.0684 = 0.4884 $$
です。
つまり、
$$ 0.352 < p < 0.488 $$
およそ、
$$ 35.2\%\sim48.8\% $$
ですね。
マナブ先生よくできました。
さてユキさん。
最初に、
「塾に通っている生徒は42%です」
とだけ聞いた場合と、
「標本比率42%、95%信頼区間は約35.2~48.8%です」
と聞いた場合では、印象は同じでしょうか?
ユキさんかなり違いますね。
42%という数字だけを見ると正確な値のように感じます。
でも実際には、200人しか調べていないので、
それなりの幅があることが分かります。
マナブ先生そうなんです。
これが区間推定の大切なところです。
推定値そのものだけでなく、その不確かさも一緒に示す。
これは品質管理でも市場調査でも重要です。
なぜ今回は \(n-1\) で割らないの?
ユキさん一つ疑問があります。
以前、母分散を標本から推定するときには、
$$ n-1 $$
で割りましたよね。
今回は標準誤差が、
$$ \sqrt{ \frac{\hat p(1-\hat p)}{n} } $$
で、\(n\) が使われています。
なぜ今回は \(n-1\) ではないんですか?
マナブ先生いい質問ですね。
ここは少し整理して考えましょう。
前に \(n-1\) が出てきたのは、
一般の数値データについて、
標本から母分散を不偏に推定するためでした。
今回は出発点が違います。
一人ひとりを、
$$ X_i= \begin{cases} 1 & \text{塾に通っている}\\ 0 & \text{通っていない} \end{cases} $$
と考えると、これはベルヌーイ分布です。
その分散は理論的に、
$$ p(1-p) $$
と分かっています。
そして \(n\) 人の平均が標本比率 \(\hat p\) なので、その分散は、
$$ \frac{p(1-p)}{n} $$
になります。
ユキさんつまり今回は、データから普通の分散を計算しているというより、
二項分布・ベルヌーイ分布の理論から
標本比率のばらつきを求めているんですね。
マナブ先生そうです。
ただし実際には \(p\) が未知なので、それを \(\hat p\) で置き換えた、
$$ \frac{\hat p(1-\hat p)}{n} $$
を使っています。
これは大標本でよく使われる近似的な方法です。
ですから、単純に、
「比率だから \(n-1\) は不要」
と覚えるより、
「今は標本比率の理論的な分散から出発している」
と理解してください。
ユキさんなるほど。
式が似ていても、どこからその式が出てきたのか
を見ることが大切なんですね。
マナブ先生その通りです。
会社で使いそうな例を考えてみよう
マナブ先生では今度は、もう少し会社らしい例です。
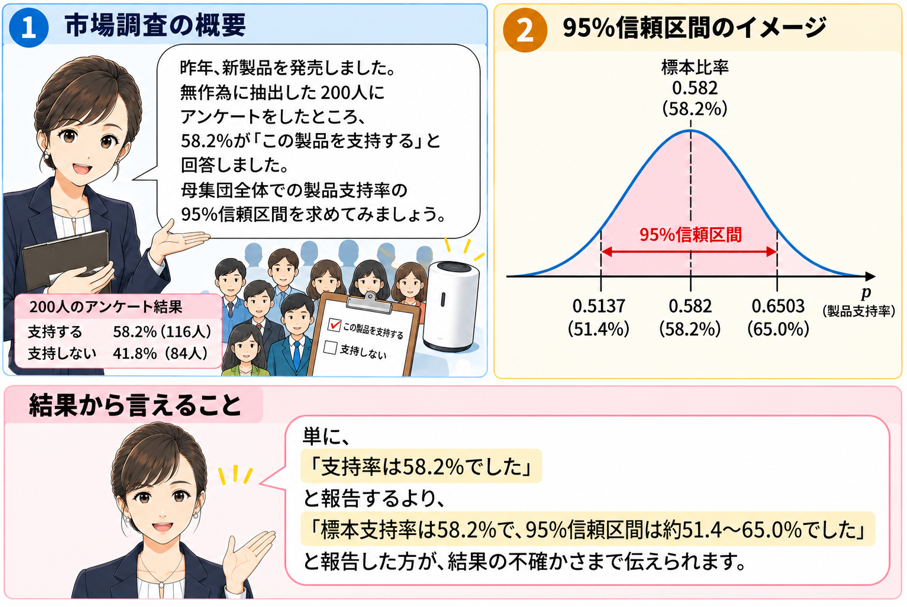
昨年、新製品を発売しました。
その製品について市場調査を行い、無作為に抽出した200人にアンケートをしたところ、
58.2%が「この製品を支持する」
と回答しました。
母集団全体での製品支持率について、95%信頼区間を求めてみましょう。
マナブ先生まず標本比率は?
ユキさん$$ \hat p=0.582 $$
です。
標準誤差は、
$$ \sqrt{ \frac{0.582(1-0.582)}{200} } $$
なので、
$$ \sqrt{ \frac{0.582\times0.418}{200} } \approx0.0349 $$
です。
マナブ先生では95%信頼区間は?
ユキさん$$ 0.582 \pm 1.96\times0.0349 $$
です。
幅は約、
$$ 0.0683 $$
なので、
$$ 0.5137 < p < 0.6503 $$
です。
したがって約、
$$ 51.4\%\sim65.0\% $$
ですね。
マナブ先生そうですね。
では、この結果から何が言えそうでしょう?
ユキさん95%信頼区間の下限でも50%を上回っています。
ですから、この標本結果からは、
母集団でも半数を超える人が製品を支持している
と考える根拠がある
と言えそうです。
マナブ先生いいですね。
単に、
「支持率は58.2%でした」
と報告するより、
「標本支持率は58.2%で、95%信頼区間は約51.4~65.0%でした」
と報告した方が、結果の不確かさまで伝えられます。
標本数を増やしたらどうなる?
マナブ先生では、同じ58.2%という結果でも、
調査人数が200人ではなく
2,000人だったらどうなると思いますか?
ユキさん標準誤差の式には、
$$ \sqrt{n} $$
が分母にあります。
だから標本数を増やせば標準誤差が小さくなって、信頼区間が狭くなります。
マナブ先生そうですね。
つまり、
同じ58.2%でも、何人を調べた結果なのかによって信頼性は違う
ということです。
ユキさんニュースで「支持率60%」という数字だけを見るのではなく、
「何人に調査したのだろう?」
ということも見た方がいいんですね。
マナブ先生その視点は、統計データを見るうえで非常に大切です。
品質管理なら「不良率」を推定する
マナブ先生品質管理では、「支持率」を何に置き換えればよいでしょう?
ユキさん不良率ですね。
例えば1,000個調べて、不良品が20個なら、
$$ \hat p = \frac{20}{1000} = 0.02 $$
です。
マナブ先生そうです。
しかし、
「この工程の不良率は2.00%です」
と断定するのではなく、
標本から母不良率の信頼区間を求めれば、
「本当の工程不良率がどの程度の範囲にありそうなのか」
まで評価できます。
ユキさん市場調査と品質管理は全然違うように見えますが、
数学的には同じなんですね。
マナブ先生そうです。
「支持する/支持しない」
「合格/不合格」
「良品/不良品」
「故障する/しない」
いずれも、基本となる考え方は共通です。
AIでも「割合の推定」は使う
ユキさんこれはAIやデータサイエンスでも使いますか?
マナブ先生もちろんです。
例えば画像検査AIを500個の製品で評価して、
490個を正しく判定したとします。
正解率は?
ユキさん$$ \frac{490}{500}=0.98 $$
なので98%です。
マナブ先生でも、本当にそのAIの「真の正解率」が
ぴったり98%だと言えるでしょうか?
ユキさん言えませんね。
別の500個なら97%だったり99%だったりするかもしれません。
マナブ先生そうですね。
ですからAIの性能評価でも、単に、
Accuracy = 98%
という一点だけを見るのではなく、
その割合がどの程度の不確かさを持っているのかを見ることが重要です。
ユキさん母比率の推定という古典的な統計の考え方が、
AIの性能評価にもそのまま使えるんですね。
今日の内容を整理してみよう
マナブ先生ではユキさん、母比率の推定を自分の言葉で説明してみてください。
ユキさんはい。
母集団全体で「A」が起こる割合を \(p\) とし、
標本 \(n\) 個の中でAが \(x\) 回起こったら、
標本比率は、
$$ \hat p=\frac{x}{n} $$
です。
これを母比率 \(p\) の点推定値として使います。
そして標本数が十分大きく、正規近似が使える場合には、
標本比率の標準誤差を、
$$ \sqrt{ \frac{\hat p(1-\hat p)}{n} } $$
と見積もります。
マナブ先生では95%信頼区間は?
ユキさん$$ \hat p \pm 1.96 \sqrt{ \frac{\hat p(1-\hat p)}{n} } $$
です。
マナブ先生そして、標本数を増やすと?
ユキさん標準誤差が小さくなって、信頼区間が狭くなります。
つまり母比率をより精度よく推定できるようになります。
マナブ先生十分です。
今回のポイント
「支持する/支持しない」「良品/不良品」のように
結果が二つに分かれる場合、
母集団全体で目的とする事象が起こる割合を母比率 \(p\) といいます。
標本 \(n\) 個のうち目的とする事象が \(x\) 回起こった場合、
標本比率は、
$$ \hat p=\frac{x}{n} $$
です。
標本比率 \(\hat p\) は母比率 \(p\) の点推定値になります。
二項分布を正規分布で近似できる程度に標本数が十分大きい場合、
95%信頼区間の代表的な近似式は、
$$ \hat p \pm 1.96 \sqrt{ \frac{\hat p(1-\hat p)}{n} } $$
です。
ここで、
$$ \sqrt{ \frac{\hat p(1-\hat p)}{n} } $$
は標本比率の標準誤差です。
大切なのは、
「42%だった」という一点だけではなく、
「その42%にはどの程度の不確かさがあるのか」を見ること。
これは世論調査、市場調査、品質管理の不良率、AIの正解率などに共通する統計的な考え方です。
あなたも考えてみましょう
ある製造工程から500個の製品を無作為に抜き取り検査したところ、
不良品が15個
見つかりました。
標本不良率は、
$$ \hat p = \frac{15}{500} = 0.03 $$
つまり3%です。
しかし、本当の工程不良率がぴったり3%だとは限りません。
では、
「この工程の本当の不良率は、どのくらいの範囲にあると考えればよいのか?」
95%信頼区間を求めてみてください。
そしてもう一つ考えてみましょう。
会社の品質目標が、
「不良率5%未満」
だったとします。
標本不良率3%という数字だけを見て、
「目標を達成している」
と判断してよいでしょうか?
それとも、信頼区間まで見て判断した方がよいでしょうか?
この、
「標本で見えた差や結果は、本当に意味があるのか?」
という問いが、これから学ぶ仮説検定へつながっていきます。
次回
次回は、
4-7.工程のばらつきを推定する
― 母分散の推定
です。
シリーズ全体の目次
『品質をデータで読み解く 統計解析・データサイエンス入門』
― 品質管理の現場で使える「見る・推定する・判断する」ための統計学 ―
全体の目次はここをご覧ください。