標本から母集団の分散を推定
 マナブ先生
ここまで、母平均や母比率を標本から推定する方法を見てきましたね。
では品質管理の立場から考えると、平均値や不良率以外に、
ぜひ知っておきたいものは何でしょう?
 ユキさん
ばらつきですか?
平均値が同じでも、ばらつきが大きければ品質は安定しているとは言えませんよね。
マナブ先生その通りです。
例えば2台の加工機がどちらも平均寸法50.00 mmだったとしても、
一方はほとんど50.00 mm付近に集まり、
もう一方は49.5 mmから50.5 mmまで大きくばらついていたら、
同じ工程とは言えませんね。
ユキさんはい。
平均値だけでなく、工程そのもののばらつきを知りたいです。
マナブ先生そこで今回は、
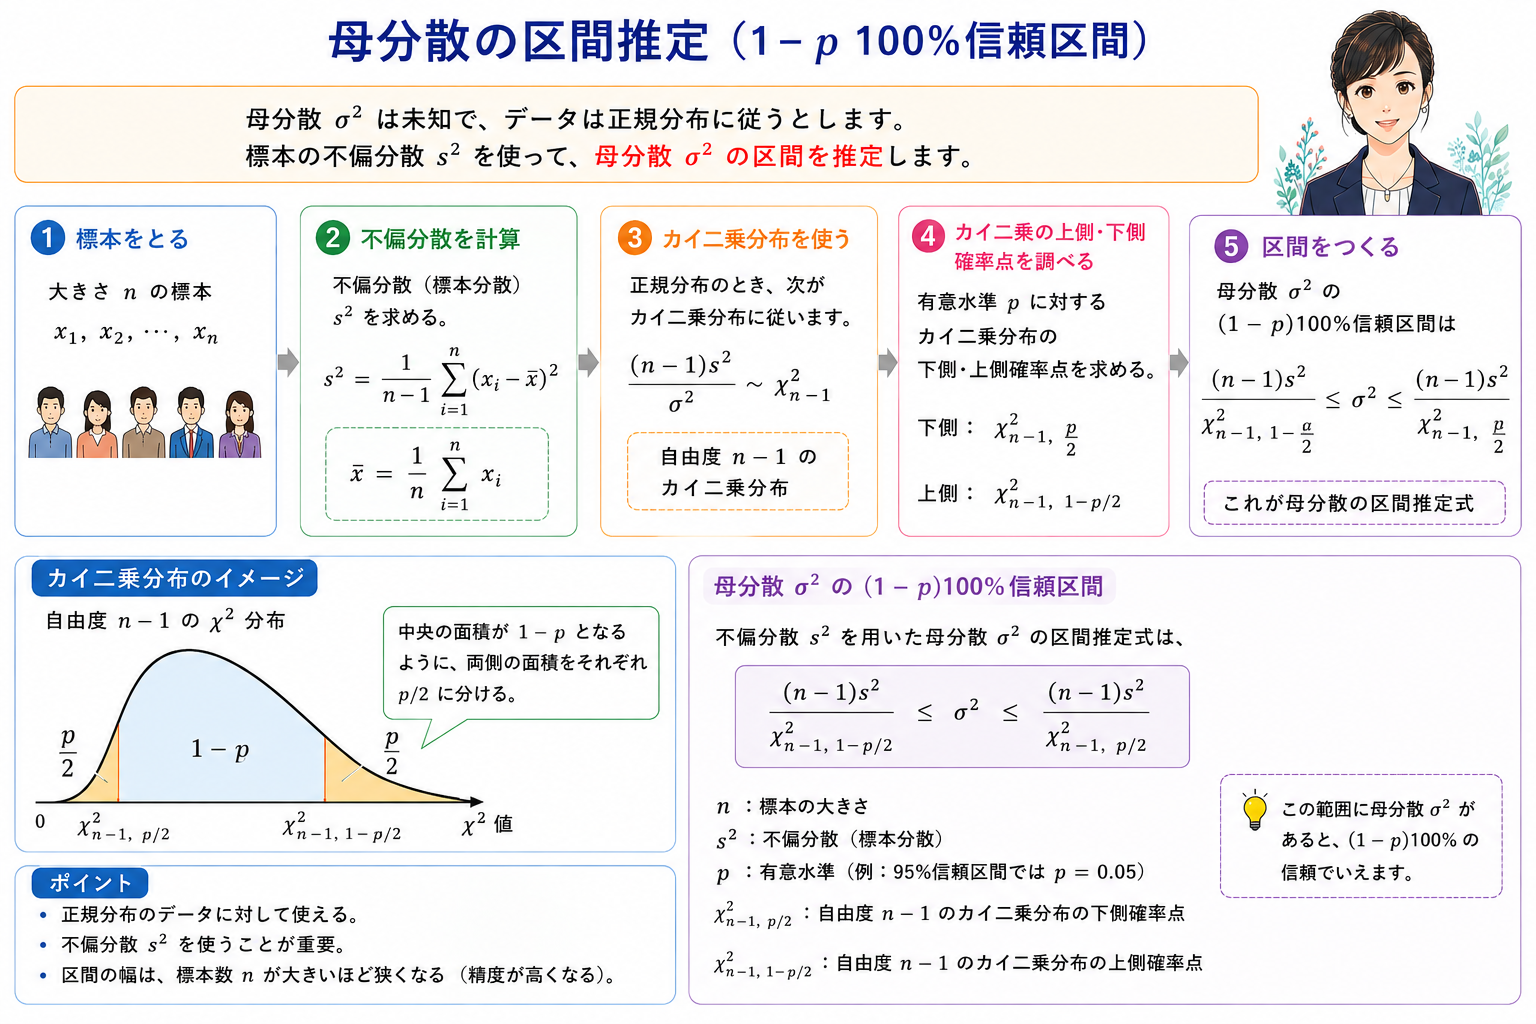
母集団の分散 \(\sigma^2\) を、標本から推定する方法
を考えます。
母分散は直接見えない
マナブ先生母集団全体の分散を、
$$ \sigma^2 $$
とします。
でも実際には、母集団全体を見ることはできません。
そこで標本を \(n\) 個取り、その標本から何を計算しましたか?
ユキさん不偏分散、
$$ s^2 = \frac{1}{n-1} \sum_{i=1}^{n}(x_i-\bar{x})^2 $$
ですね。
マナブ先生そうです。
\(s^2\) は母分散 \(\sigma^2\) の点推定値として使えます。
でも、別の標本を取り直したら \(s^2\) は同じになるでしょうか?
ユキさんならないですね。
標本によって分散も少しずつ変わります。
マナブ先生その通りです。
では、
「標本分散 \(s^2\) がどのようにばらつくのか」
が分かれば、逆に母分散 \(\sigma^2\) の範囲を推定できそうですね。
そのときに登場するのが、
χ²分布(カイ二乗分布)
です。
 ユキさん
カイ二乗ですか?
難しそうな名前ですね。
χ²分布はどこから出てくる?
マナブ先生母集団が正規分布、
$$ N(\mu,\sigma^2) $$
に従っているとします。
この母集団から \(n\) 個の標本を独立に取り出し、不偏分散 \(s^2\) を求めます。
すると、
$$ \chi^2 = \frac{(n-1)s^2}{\sigma^2} $$
という量は、自由度
$$ \nu=n-1 $$
のχ²分布に従います。
母集団が正規分布、
$$ N(\mu,\sigma^2) $$
に従うとき、標本数 \(n\)、標本不偏分散 \(s^2\) について、
$$ \chi^2 = \frac{(n-1)s^2}{\sigma^2} $$は、
自由度、
$$ \nu=n-1 $$
のχ²分布に従う。
ユキさんまた自由度 \(n-1\) が出てきましたね。
マナブ先生そうですね。
不偏分散を計算するとき、標本平均 \(\bar{x}\) を使ったため、自由に変化できる偏差は \(n-1\) 個でしたね。
そのためここでも自由度は、
$$ n-1 $$
になります。
ユキさんということは、\(t\)分布と同じように、
χ²分布も自由度によって形が変わるんですか?
マナブ先生その通りです。
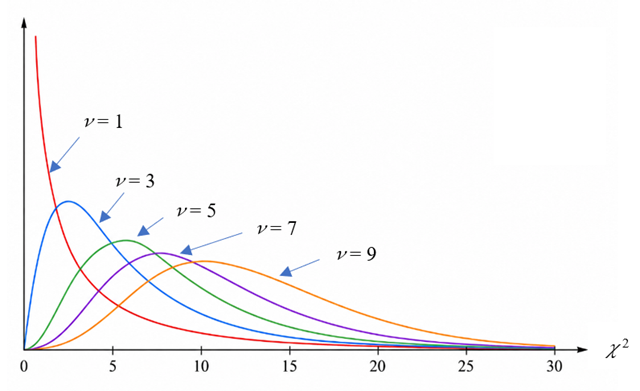
自由度\(\nu\)を変化させて描いたχ²分布のグラフを示します。
 マナブ先生
例えば自由度が小さいと、かなり左に寄った形になります。
自由度を大きくすると、だんだん左右対称に近い形になっていきます。
ユキさん正規分布とはかなり違いますね。
負の値もないんですね。
マナブ先生いいところに気づきました。
χ²は、偏差の二乗に関係する量です。
二乗した値は負になりませんから、
$$ \chi^2\ge0 $$
です。
そのためχ²分布は0より左には存在しません。
ユキさんχ²分布のパーセント点も
自由度ごとに数値が与えられている表があるのですよね?
マナブ先生そうです。
それがこれになります。
各列の最上段の数字がパーセント点で上側確率を表します。
マナブ先生では、χ²分布の95%中央区間を考えてみましょう。
標本数が、
$$ n=20 $$
だったとします。
自由度は?
ユキさん$$ 20-1=19 $$
です。
マナブ先生中央95%を残すなら、左右には何%ずつ残りますか?
ユキさん2.5%ずつです。
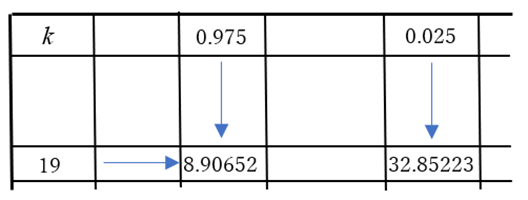
マナブ先生では自由度19のχ²分布表から、
下側2.5%点と上側2.5%点を探してみましょう。
χ²分布は上下の値が対称ではない
 ユキさん
χ²パーセント点表の縦側が自由度を表して、
横がパーセント点なのですね。
パーセント点の数字がちょっと正規分布表などとは違いますが...
マナブ先生χ²分布表では、教科書によって表の作り方が異なることがあります。
例えば今回使う表が、
「右側に残る確率」
つまり上側確率を示す表だとします。
下側2.5%点を探したい場合、右側には何%残っていますか?
ユキさん97.5%ですね。
マナブ先生そうです。
したがって、上側確率の表なら、
下側2.5%点 ⇒ 0.975の列
上側2.5%点 ⇒ 0.025の列
を見ます。
ユキさんなるほど。
数字だけを見るのではなく、
「表の確率がどこの面積を表しているか」
を確認しないと間違えますね。
マナブ先生その通りです。
これは正規分布表や\(t\)分布表でも同じでしたね。
ユキさんそれでは表を見てみます。
下側2.5%点は、
$$ 8.907 $$
くらい。
上側2.5%点は、
$$ 32.852 $$
くらいです。
 マナブ先生
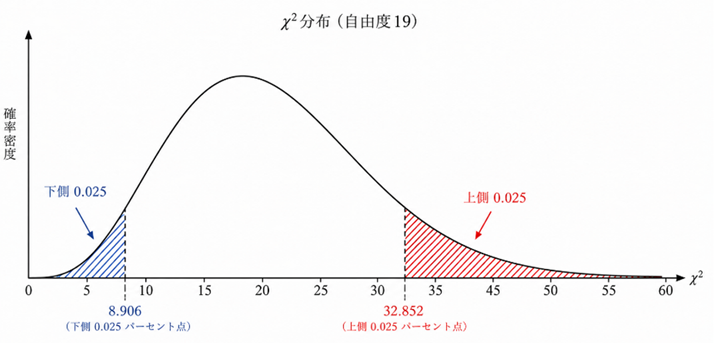
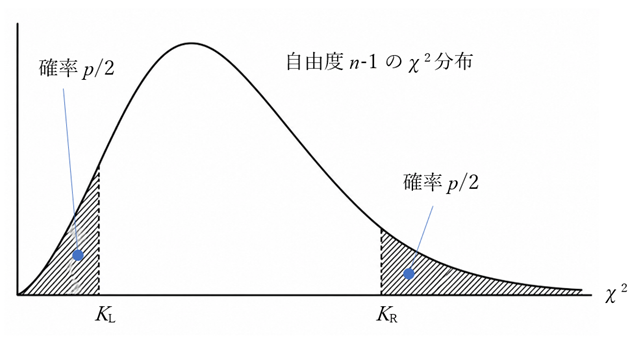
χ²分布のグラフを示しますが、正規分布とはかなり違いますね。
 ユキさん
正規分布なら左右対称なので、
\(-1.96\) と \(1.96\) のようになりますが、
χ²分布では全然対称ではありません。
 マナブ先生
そうです。
χ²分布は右に歪んでいるので、
下側と上側を別々に求める必要があります。
ここはとても大切です。
Excelではどう求める?
ユキさんこれもExcelで計算できますよね?
マナブ先生もちろんです。
現在のExcelなら、主に次の関数を使います。
| 内容 | 関数名 |
| χ²値・自由度→右側確率を求める | CHISQ.DIST.RT(χ²値,自由度) |
| 右側確率・自由度→χ²値を求める | CHISQ.INV.RT(右側確率,自由度) |
| 左側確率・自由度→χ²値を求める | CHISQ.INV(左側確率,自由度) |
マナブ先生例えば自由度19で、上側2.5%点なら、
CHISQ.INV.RT(0.025,19)
で、
$$ 32.852 $$
程度が得られます。
下側2.5%点なら、
CHISQ.INV(0.025,19)
で、
$$ 8.907 $$
程度です。
ユキさん上側と下側で関数も違うので、
逆に間違いにくいかもしれませんね。
では、母分散はどう推定する?
ユキさんχ²分布の形や表の見方は分かってきました。
でも、これをどうやって母分散 \(\sigma^2\) の推定につなげるんですか?
マナブ先生そこが本題ですね。
先ほどの、
$$ \chi^2 = \frac{(n-1)s^2}{\sigma^2} $$
を使います。
自由度 \(n-1\) のχ²分布について、中央95%に入る範囲を、
$$ \chi^2_{0.025} \le \frac{(n-1)s^2}{\sigma^2} \le \chi^2_{0.975} $$
と考えます。
ただし、記号の添字は教科書によって「上側確率」か「下側確率」かが違うので注意が必要です。
ここでは分かりやすく、
$$ K_L=\text{下側2.5%点} $$ $$ K_U=\text{上側2.5%点} $$
と書きましょう。
すると、
$$ K_L \le \frac{(n-1)s^2}{\sigma^2} \le K_U $$
です。
これを \(\sigma^2\) について解くとどうなりますか?
ユキさん逆数を取るので不等号の向きに注意して……
$$ \frac{(n-1)s^2}{K_U} \le \sigma^2 \le \frac{(n-1)s^2}{K_L} $$
ですね。
マナブ先生その通りです。
 マナブ先生
母集団が正規分布に従うとき、
$$ \frac{(n-1)s^2}{\chi^2_{0.975}} \le \sigma^2 \le \frac{(n-1)s^2}{\chi^2_{0.025}} $$
という形で求められます。
ここで、添字を下側累積確率で表すなら、
$$ \chi^2_{0.025} $$
が下側2.5%点、
$$ \chi^2_{0.975} $$
が上側側の境界に対応する大きな値です。
ユキさん分母の大きいχ²値が下限、
分母の小さいχ²値が上限になるんですね。
マナブ先生そうです。
ここは逆になりやすいので、式だけでなく、
「大きな数で割れば小さくなる」
と考えると間違いにくいですよ。
テストの点数で計算してみよう
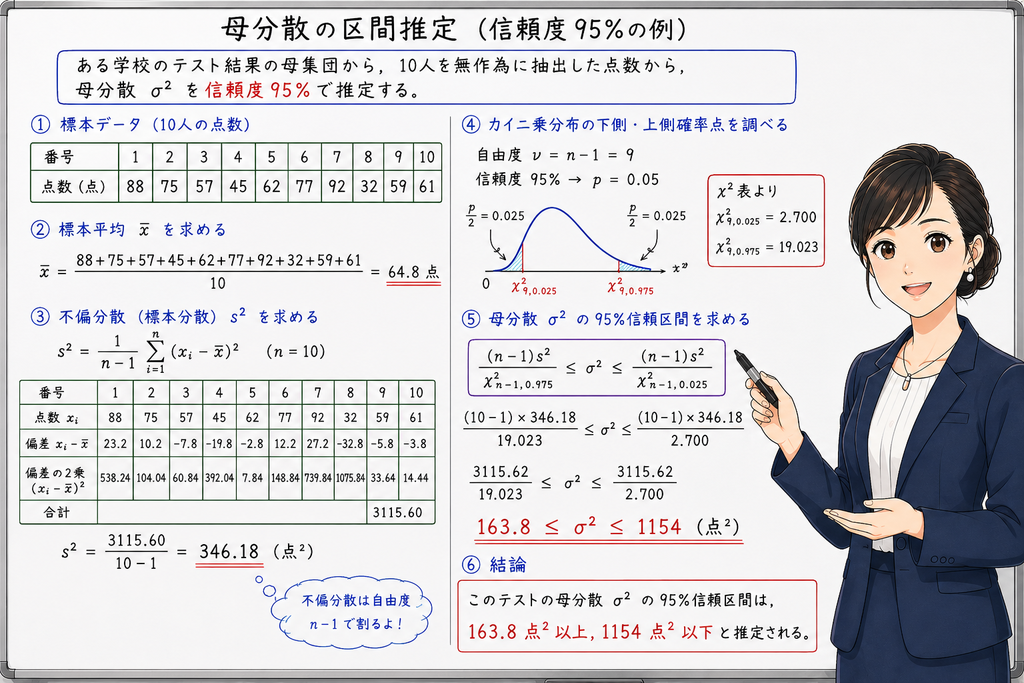
マナブ先生では以前使った10人のテストの点数を、ある母集団から無作為に取り出した標本だと考えてみましょう。
$$ 88,\ 75,\ 57,\ 45,\ 62,\ 77,\ 92,\ 32,\ 59,\ 61 $$
このとき、母分散 \(\sigma^2\) の95%信頼区間を求めます。
まず何が必要ですか?
ユキさん標本数 \(n\) と不偏分散 \(s^2\) です。
標本数は、
$$ n=10 $$
なので、自由度は、
$$ \nu=9 $$
です。
不偏分散は以前計算して、
$$ s^2=346.18 $$
くらいでした。
マナブ先生そうですね。
偏差平方和は、
$$ 3115.6 $$
なので、
$$ s^2 = \frac{3115.6}{9} = 346.18 $$
です。
ユキさん標本比率は、
$$ \hat p=0.42 $$
です。
標準誤差は、
$$ \sqrt{ \frac{0.42\times0.58}{200} } $$
なので、
$$ \sqrt{0.001218} \approx0.0349 $$
です。
95%信頼区間の幅は、
$$ 1.96\times0.0349 \approx0.0684 $$
ですね。
したがって、
$$ 0.42-0.0684 = 0.3516 $$ $$ 0.42+0.0684 = 0.4884 $$
です。
つまり、
$$ 0.352 < p < 0.488 $$
およそ、
$$ 35.2\%\sim48.8\% $$
ですね。
マナブ先生自由度9のχ²分布で、中央95%を残す境界値を求めましょう。
ユキさん下側2.5%点は、
$$ 2.700 $$
上側2.5%点は、
$$ 19.023 $$
くらいですね。
マナブ先生では式に入れてみましょう。
ユキさん下限は、
$$ \frac{9\times346.18}{19.023} $$
なので、
$$ \approx163.8 $$
です。
上限は、
$$ \frac{9\times346.18}{2.700} $$
なので、
$$ \approx1154 $$
です。
したがって母分散の95%信頼区間は、
$$ 163.8 \le \sigma^2 \le 1154 $$
ですね。
マナブ先生そうです。
 ユキさん
でも分散で、
$$ 163.8\sim1153.8 $$
と言われても、少しイメージしにくいですね。
マナブ先生では平方根を取って、母標準偏差 \(\sigma\) の範囲にしてみましょう。
ユキさん$$ \sqrt{163.8} \approx12.8 $$ $$ \sqrt{1154} \approx34.0 $$
です。
したがって、
$$12.8 \le \sigma \le 34.0 $$
点くらいですね。
マナブ先生どう感じますか?
ユキさんかなり広いです。
これでは母集団のばらつきがどれくらいなのか、
あまり絞り込めていない感じですね。
マナブ先生では、なぜこれほど広いのでしょう?
ユキさん標本が10人しかいないからでしょうか。
マナブ先生その通りです。
平均値の推定でも標本数が少ないと信頼区間が広くなりましたね。
分散の推定でも同じです。
しかも、分散は平均より推定が不安定になりやすい量です。
ユキさん確かに、たまたま1人だけ極端に高い点や低い点が入るだけでも、
分散はかなり変わりますね。
マナブ先生そこです。
ばらつきを精度よく推定するには、ある程度の標本数が必要です。
では比較のために、標本数を、
$$ n=300 $$
とします。
不偏分散は同じ、
$$ s^2=346.2 $$
だったと仮定しましょう。
自由度は?
ユキさん$$ 299 $$
です。
マナブ先生自由度299のχ²分布について、中央95%の境界はおよそ、
$$ 252.99 $$
と、
$$ 348.79 $$
です。
では計算してみましょう。
ユキさん母分散の下限は、
$$ \frac{299\times346.2}{348.79} \approx296.8 $$
上限は、
$$ \frac{299\times346.2}{252.99} \approx409.2 $$
です。
したがって、
$$ 296.8 \le \sigma^2 \le 409.2 $$
ですね。
標準偏差なら、
$$ \sqrt{296.8} \approx17.2 $$ $$ \sqrt{409.2} \approx20.2 $$
なので、
$$ 17.2 \le \sigma \le 20.2 $$
点くらいです。
マナブ先生10人のときと比べるとどうですか?
ユキさんずっと狭くなりました。
これなら母集団の標準偏差が18点前後だということが、
かなり見えてきます。
マナブ先生そうですね。
これも、
標本数が増えると推定の精度が高くなる
ということの一例です。
自由度が大きくなるとχ²分布はどうなる?
ユキさん自由度299のχ²分布はまだ見ていませんが、
自由度が増えると右への歪みがだんだん小さくなっていくんですよね。
最終的には正規分布になるのでしょうか?
マナブ先生いいところに気づきましたね。
自由度を大きくすると、
χ²分布は左右対称に近い形になっていきます。
厳密には、自由度 \(\nu\) のχ²分布そのものは、
平均が、
$$ \nu $$
分散が、
$$ 2\nu $$
なので、自由度が増えると中心位置も右へ移動します。
ただし、標準化すると正規分布に近づいていきます。
ユキさんでは、「χ²分布そのものがそのまま標準正規分布になる」というより、
形が正規分布に近づいていく
と考えた方がよいんですね。
マナブ先生その通りです。
χ²分布を使うときの重要な条件
マナブ先生そして、ここで非常に重要な条件を一つ確認しておきましょう。
今回の、
$$ \frac{(n-1)s^2}{\sigma^2} $$
がχ²分布に従うという結果は、
母集団が正規分布に従っていること
が前提です。
ユキさん母平均の推定では中心極限定理によって、
標本数が多ければかなり対応できましたよね。
母分散では、正規性がもっと重要なんですか?
マナブ先生そうです。
母分散のχ²による区間推定は、母集団の正規性に比較的敏感です。
ですから実務では、
・ヒストグラム、
・過去の工程知識
なども使って、正規分布を仮定してよいか確認することが大切です。
ユキさん公式に入れる前に、まずデータを見る。
また最初の話に戻ってきましたね。
マナブ先生そうです。
統計解析では結局、
「この公式が使える条件は満たされているか」
を考えることがとても重要なんです。
品質管理ではどんな場面で使う?
ユキさん母分散の推定は、品質管理ではどんなときに使いますか?
マナブ先生例えば、
新しい加工機の寸法ばらつき、
充填機の充填量のばらつき、
測定装置の測定ばらつき、
材料強度のばらつき
などです。
平均値が目標値に合っていても、
ばらつきが大きければ規格外品が増える可能性があります。
ユキさん平均値だけを合わせれば品質が良い、というわけではないんですね。
マナブ先生そうです。
品質管理では、
中心とばらつきの両方を見る
という考え方が基本です。
AI・データサイエンスでも「ばらつき」は重要
ユキさんこれはAIやデータサイエンスでも同じでしょうか?
マナブ先生もちろんです。
例えばAIモデルを何度も学習させたとき、
平均的な精度だけでなく、
結果がどのくらいばらつくか
を見ることがあります。
平均精度がどちらも95%でも、
あるモデルは毎回94~96%、
別のモデルは85~99%
だったら、評価は変わりますよね。
ユキさん後者は不安定ですね。
マナブ先生そうです。
データサイエンスでも、
平均だけでなく、ばらつきの大きさとその不確かさを見る
という考え方は変わりません。
今日の内容を整理してみよう
マナブ先生ではユキさん、今日のポイントをまとめてみてください。
ユキさん母集団が正規分布に従っているとき、
標本数 \(n\)、不偏分散 \(s^2\) について、
$$ \frac{(n-1)s^2}{\sigma^2} $$
は自由度、
$$ n-1 $$
のχ²分布に従います。
マナブ先生そうですね。
ユキさんそのχ²分布の上下のパーセント点を使えば、
母分散 \(\sigma^2\) の信頼区間を求めることができます。
そして標本数が増えるほど、
一般には信頼区間が狭くなって、
母分散をより精度よく推定できます。
マナブ先生では、一番注意する条件は?
ユキさん母集団が正規分布に従っていること。
ですね。
マナブ先生その通りです。
今回のポイント
母集団が正規分布、
$$ N(\mu,\sigma^2) $$
に従うとき、標本数 \(n\)、標本不偏分散 \(s^2\) について、
$$ \chi^2 = \frac{(n-1)s^2}{\sigma^2} $$
は、自由度、
$$ \nu=n-1 $$
のχ²分布に従います。
χ²分布は0以上の値を取り、自由度が小さいと右に大きく歪んだ形になります。
この性質を利用すると、母分散 \(\sigma^2\) の95%信頼区間は、
$$ \frac{(n-1)s^2}{\chi^2_{0.975}} \le \sigma^2 \le \frac{(n-1)s^2}{\chi^2_{0.025}} $$
という形で求められます。
標本数が少ない場合、母分散や母標準偏差の信頼区間はかなり広くなることがあります。
標本数を増やすと、推定の精度は高くなります。
そして最も重要なのは、
χ²分布を使った母分散の推定では、母集団が正規分布に従うという前提が重要である。
という点です。
あなたも考えてみましょう
ある充填工程から10本を無作為に取り出して充填量を調べたところ、
標本標準偏差は、
$$ s=1.5\ \mathrm{mL} $$
でした。
別の日に100本を測定したところ、偶然同じく、
$$ s=1.5\ \mathrm{mL} $$
だったとします。
どちらも標本標準偏差は同じ1.5 mLです。
では、
「母集団の本当の標準偏差も1.5 mLくらいだ」
と、より自信を持って言えるのはどちらでしょう?
おそらく100本の方だと感じるでしょう。
その「自信の違い」を数値として表してくれるのが、
χ²分布を使った母分散・母標準偏差の信頼区間
なのです。
次回
次回から、
第5章 その差は偶然か?
― 仮説検定でデータから判断する ―
に入ります。
いよいよ「仮説検定」の話です。
最初は
5-1.「差がある」と言ってよいのか
― 仮説検定の考え方
です。
シリーズ全体の目次
『品質をデータで読み解く 統計解析・データサイエンス入門』
― 品質管理の現場で使える「見る・推定する・判断する」ための統計学 ―
全体の目次はここをご覧ください。