初めに
 ユキさん
今回、品質保証課に異動になりました桜木ユキです。
主に内部監査などの品質保証業務を担当することになりました。
よろしくお願いします。
 マナブ先生
こちらこそ、よろしくお願いします。
品質保証課ということは、監査だけではなく、
製造工程の品質データを見る機会もありそうですね。
 ユキさん
そうなんです。
工場の製品の不良率を解析したり、工程データを確認したりと、
品質管理にも関係することになりました。
でも私、確率とか統計とかがあまり得意ではなくて……。
今、かなり悪戦苦闘しています。
マナブ先生なるほど。
ではユキさん、「統計」と聞くと、どんなものを思い浮かべますか?
 ユキさん
うーん……。
平均とか、標準偏差とか、正規分布とか……。
あとは、何だか難しそうな数式がたくさん出てくるイメージです。
 マナブ先生
確かに、統計学の教科書を開くと数式がたくさん並んでいますからね。
でも、品質管理で統計を使う目的は、数式を解くことでしょうか?
ユキさん言われてみれば……違いますよね。
製品や工程の状態を知るため、でしょうか。
マナブ先生その通りです。
もう少し踏み込むと、
「データから、実際に何が起きているのかを考え、判断する」
ために統計を使います。
数式は、そのための道具なんです。
ユキさん「統計=計算」ではなくて、
「統計=データから判断するための道具」ということですか?
マナブ先生そう考えると、かなり分かりやすくなると思います。
実際、品質管理で必要になる基本的な統計の考え方は、
順番に理解していけば、
それほど難しいものではありません。
ユキさんそうだといいのですが……。
自分でも教科書を読んで勉強してようとしているんですけど、
なかなか頭に入らなくて。
マナブ先生自分で調べようとしているのは大切ですね。
ただ、最初から数式だけを追いかけるより、
「何を知りたいのか?」
「なぜこの計算をするのか?」
を先に考えた方が理解しやすいんですよ。
ユキさんそれなら、ぜひマナブ先生に教えていただきたいです。
コンサルティングだけではなく、
技術を教えるのも上手だと聞いていますので。
マナブ先生分かりました。
では、私が一方的に説明するのではなく、
ユキさんにもいろいろ考えてもらいながら進めていきましょう。
ユキさんはい。お願いします。
現場の悩み「違いがある?」
マナブ先生まず、今の仕事で「統計を使えたらいいのに」と思っていることはありますか?
ユキさん実は、ちょうどあるんです。
工場の担当者から、こんな相談を受けています。
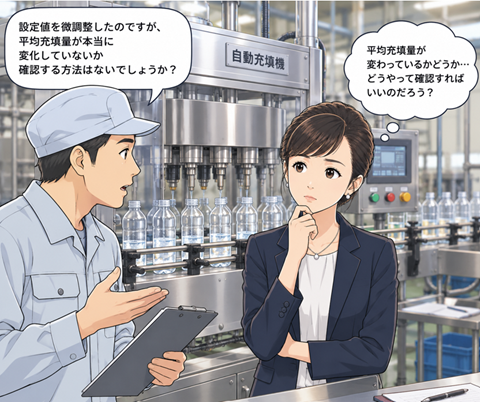
この工場では、自動充填機で液体製品をボトルに充填している。
充填量を適切に保つため、担当者が充填機の設定値を微調整することがある。
担当者から、
「微調整を行った後、平均充填量が本当に変化していないか確認する方法はないか?」
と相談された。
 ユキさん
これは確か、「検定」という方法を使えばいいんですよね?
マナブ先生そうですね。
でも、その前に少し考えてみましょう。
例えば、調整前の平均充填量が500.0 mLだったとします。
調整後に10本測定したら、平均が500.4 mLになりました。
ユキさんなら、どう判断しますか?
ユキさん0.4 mL増えていますから……。
平均充填量が変わった、と言いたくなります。
マナブ先生では、別の日にもう一度10本測定したら、平均が499.8 mLだったら?
ユキさん今度は0.2 mL減っていますね。
……あれ?
測るたびに少しずつ違うということですか?
マナブ先生そうなんです。
製品の充填量には、必ずばらつきがあります。
同じ機械、同じ設定で充填していても、
すべてのボトルが完全に500.000 mLになるわけではありません。
ユキさんということは、500.0 mLから500.4 mLになったとしても、それだけでは設定変更の影響なのか、たまたまなのか分からない?
マナブ先生そこが重要です。
品質データを見るときには、
「違いがある」
ことと、
「意味のある違いがある」
ことを分けて考えなければなりません。
ユキさんなるほど……。
そこで「検定」が必要になるんですね。
マナブ先生そうです。
検定は簡単に言えば、
「この違いは、単なる偶然のばらつきとして説明できるのか。」
それとも、
「本当に何かが変化したと考えるべきなのか」
をデータから判断するための方法です。
ユキさんそう説明されると、「検定」という言葉が少し身近に感じます。
マナブ先生統計解析は、まさにこうした問題を扱うためのものです。
では、ここで少し視野を広げてみましょう。
ビッグデータ・データサイエンスなど
マナブ先生最近、「データサイエンス」という言葉をよく聞きませんか?
ユキさん聞きます。
ビッグデータとかAIと一緒に出てくるイメージがあります。
携帯電話の通信データとか、顧客データとか、
ものすごく大量のデータを扱うものですよね。
 マナブ先生
そうですね。
では、工場はどうでしょう。
工場にも「大量のデータ」はありませんか?
ユキさん工場ですか?
……考えてみると、かなりありますね。
温度とか圧力とか、生産数とか、不良率とか。
マナブ先生その通りです。
現在の製造設備では、それだけではありません。
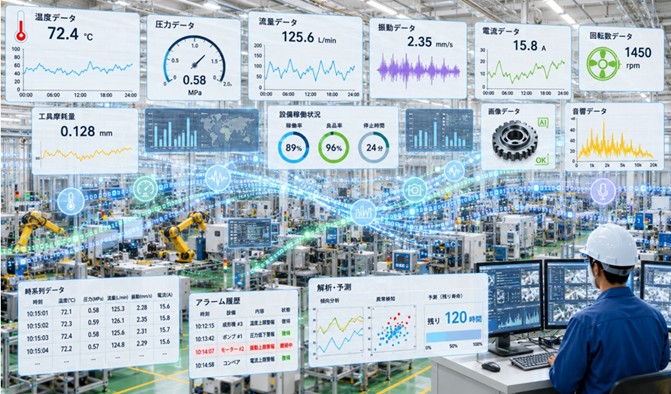
温度、圧力、流量、振動、電流、回転数、工具摩耗量、画像、音響データ……。
センサーやIoT技術の発達によって、
以前とは比較にならないほど大量のデータを
リアルタイムで取得できるようになっています。
ユキさんそう考えると、工場も「ビッグデータ」の世界なんですね。
 マナブ先生
まさにそうです。
そして、その大量のデータから意味のある情報を取り出し、
予測や判断、さらには価値創造につなげようとする
のがデータサイエンスです。
ユキさんでは、統計解析とデータサイエンスは別のものなんですか?
マナブ先生いい質問ですね。
ユキさんは、どういう関係だと思いますか?
ユキさんうーん……。
データサイエンスの中に統計解析が入っている、
という感じでしょうか。
マナブ先生そう考えると分かりやすいですね。
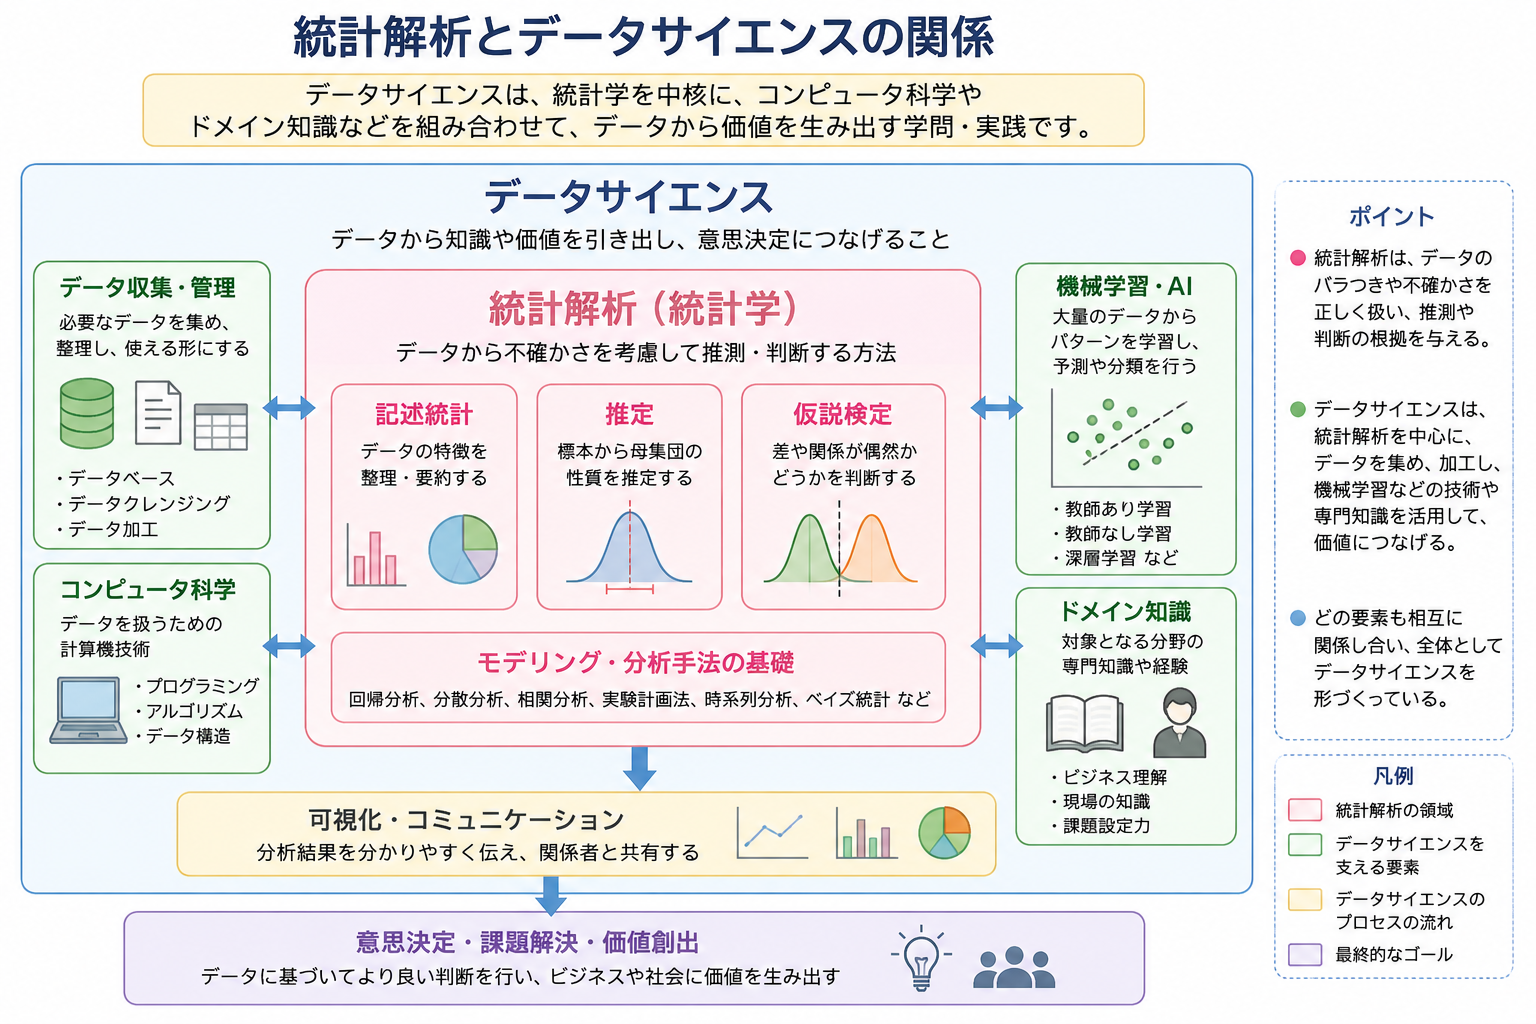
データサイエンスは、統計学だけではありません。
大まかなイメージとしては、
データサイエンス
= 統計学・統計解析
+ 数学
+ コンピュータ科学
+ 機械学習・AI
+ 対象分野の専門知識
と考えることができます。
 ユキさん
統計解析は、データサイエンスの基礎の一つということですね。
マナブ先生そうです。
AIが発展するほど…
マナブ先生ただし、「統計解析は古くて、AIは新しい」という関係ではありません。
むしろAIやデータサイエンスが発展するほど、
統計的な考え方は重要になってきます。
ユキさんどうしてですか?
AIが発達すれば、人間が統計を知らなくても、
AIが全部計算してくれるような気もしますけど。
マナブ先生そこが面白いところです。
例えば、工場のデータをAIに分析させたところ、
「この製品が不良になる確率は87%です」
という結果が出たとしましょう。
ユキさんなら、どうしますか?
ユキさん87%なら、かなり高いですよね。
「不良になる可能性が高い」、
と判断します。
マナブ先生では、その87%という数字を、そのまま信じていいでしょうか?
ユキさん……と言われると、ちょっと怖いですね。
マナブ先生では、何を確認したくなりますか?
ユキさん例えば……
「どんなデータを使ったの?」
とかでしょうか。
マナブ先生いいですね。他には?
ユキさんデータの数が十分なのか。
それから……特定の製品ばかりデータに入っていないか、とか。
マナブ先生まさにそれです。
技術者なら、さらにこんな疑問を持つでしょう。
「87%という数字は、どの程度信頼できるのか?」
「学習に使ったデータに偏りはないのか?」
「別の製造ラインでも同じ結果になるのか?」
「別の工場でも再現できるのか?」
「そもそも、不良と関係のないデータを使っていないか?」
ユキさんAIが答えを出してくれても、
その答えが正しいかどうかを判断するのは
人間なんですね。
マナブ先生その通りです。
そして、今、ユキさんが考えた
「その数字はどこまで信用できるのか?」
という問いこそ、統計的な思考なんです。
ユキさんなるほど。
そうすると、AIの時代だから統計学がいらなくなるのではなくて、
むしろ
統計学を理解していないとAIの結果を正しく評価できない
ということですね。
マナブ先生非常に大切なポイントです。
今後、平均や標準偏差、検定統計量などを
人間が電卓で計算する機会は、
相対的には少なくなっていくでしょう。
コンピュータやAIに任せれば、複雑な計算も一瞬でできます。
ユキさんそれなら、計算方法を覚える必要はなくなるのでしょうか?
マナブ先生「計算作業」の重要性は下がっても、
「なぜ、その計算をするのか」
を理解する重要性は下がりません。
むしろ、より重要になるでしょう。
なぜだと思いますか?
ユキさんコンピュータは計算してくれます。
AIは答えらしきものも示してくれます。
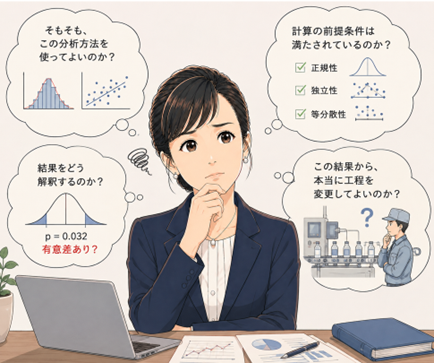
でも、
「そもそも、この分析方法を使ってよいのか?」
「計算の前提条件は満たされているのか?」
「結果をどう解釈するのか?」
「この結果から、本当に工程を変更してよいのか?」
といった判断は、
品質や製品、工程を理解している人が行わなければならないから…でしょうか?
 マナブ先生
その通りです。
ユキさん最初に先生が言った、
「統計は計算ではなく、データから判断するための道具」
という話につながりますね。
マナブ先生そうです。
そして、データサイエンスが発展して、扱えるデータ量やモデルが巨大になるほど、
「データをどう見て、どう考え、どう判断するか」
という基礎的な統計的思考の重要性は、むしろ増していくと思います。
ユキさん統計学って、昔からある学問というイメージだったんですけど、
AIの時代にもつながっているんですね。
マナブ先生そうなんです。
今日の内容を整理してみよう
マナブ先生では、ここで今日の話を整理してみましょう。
ユキさん、品質管理で統計解析を使う目的を、一言で言うと何でしょう?
ユキさんええと……。
「データから、実際に何が起きているのかを考えて判断するため」
でしょうか。
マナブ先生いいですね。
では、データサイエンスと統計解析の関係は?
ユキさんデータサイエンスは、統計解析だけではなく、数学やコンピュータ科学、機械学習・AI、それから対象となる分野の専門知識などを組み合わせて、データから予測や判断、価値を生み出していくもの。
そして、その中で統計解析は重要な基礎の一つになっている。
マナブ先生十分です。
もう一つ。
AIが発達したら、統計学は必要なくなるでしょうか?
ユキさんいいえ。
計算そのものはAIやコンピュータに任せられるようになっても、
「その結果をどこまで信頼してよいのか」
「なぜその結果になったのか」
「その結果から何を判断するのか」
を考えるために、統計的な考え方はむしろ重要になる。
マナブ先生完璧です。
では、統計解析を勉強する意味が少し見えてきましたか?
ユキさんはい。
最初は「検定の計算方法を覚えなければ」と思っていました。
でも、その前に
「データをどう考えるか」
を理解する必要があるんですね。
マナブ先生その通り。
ですから、いきなり検定の公式から始めるのはやめましょう。
ユキさんえっ、そうなんですか?
マナブ先生まず土台からです。
ところでユキさん、「正規分布」は知っていますか?
ユキさん名前は知っています。
釣鐘みたいな形のグラフですよね。
標準偏差という言葉も知っています。
ただ、それを品質管理でどう使うのかとなると……まだよく分かりません。
マナブ先生それなら、ちょうどいいですね。
正規分布を理解する前に、
もっと基本的なところから考えていきましょう。
例えば、10個の製品を測定したとします。
その10個のデータを渡されたら、
「この製品は、だいたいどのくらいの値なのか?」
そして、
「どのくらいばらついているのか?」
を、どうやって表しますか?
ユキさん「だいたいどのくらい」は平均でしょうか。
でも、「どのくらいばらついているか」は……。
マナブ先生そこから始めましょう。
平均、中央値、分散、標準偏差。
一つひとつの意味が分かってくると、
やがて正規分布が分かり、
推定が分かり、
そしてユキさんが最初に知りたかった
「検定」につながっていきます。
ユキさん検定だけを覚えるのではなく、
そこまで順番につながっているんですね。
マナブ先生そうです。
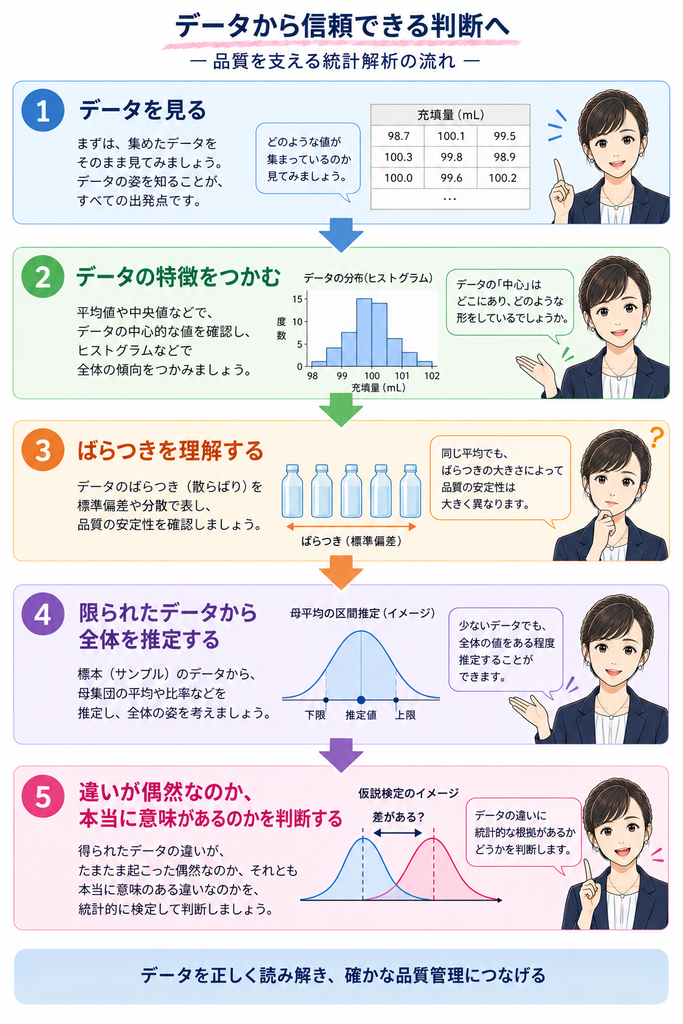
統計解析は、バラバラの公式を覚える学問ではありません。
データを見る
↓
データの特徴をつかむ
↓
ばらつきを理解する
↓
限られたデータから全体を推定する
↓
違いが偶然なのか、本当に意味があるのかを判断する
という一つの流れとして理解すると、ずっと分かりやすくなります。
ユキさんそれなら、私にもできそうな気がしてきました。
 マナブ先生
次回から、身近なデータを使いながら一緒に考えていきましょう。
計算式を覚えることより、
「この数字は何を意味しているのだろう?」
と考えることを大切にしてください。
ユキさんはい。
品質管理は「データを見る」ことから始まるのですね。
よろしくお願いします!
こうして、ユキさんとマナブ先生の
「品質をデータで読み解くための統計解析」
の勉強会が始まりました。
今回のポイントを再び
品質管理における統計解析の目的は、
単に平均や標準偏差を計算することではありません。
重要なのは、
「データから何が起きているのかを読み取り、適切な判断につなげること」
です。
製品や工程には必ず「ばらつき」があります。
そのため、データに違いが見つかったとしても、
「本当に何かが変化したのか?」
それとも、
「偶然のばらつきなのか?」
を考える必要があります。
そして現在では、製造現場から取得できるデータは飛躍的に増え、
統計解析はデータサイエンス、機械学習、AIへとつながっています。
AIが高度になるほど、人間に求められるのは「計算する力」だけではありません。
その判断を支えるのが統計解析です。
・データを見る力。
・結果を疑う力。
・意味を考える力。
・そして、データに基づいて判断する力。
これらを身につけるための基礎となるのが、統計的な考え方なのです。
あなたも考えてみましょう
あなたの職場にも、たくさんの「データ」があるはずです。
品質、不良、設備、検査、クレーム、生産量、温度、圧力、時間、コスト……。
では、その数字をあなたは「記録」しているだけでしょうか?
それとも、そこから
「何が起きているのか?」
「なぜ起きているのか?」
「これから何が起こりそうなのか?」
「では、どう判断すればよいのか?」
まで考えているでしょうか。
統計解析の第一歩は、難しい公式を覚えることではありません。
目の前のデータに「これは何を意味しているのだろう?」と問いかけること。
そこから、データで品質を読み解く力が始まります。
次回
次回はデータの「らしさ」を数字でつかむための
第2章 データの特徴をつかむ ― 代表値・ばらつき・ヒストグラム ―
2-1.データの「真ん中」はどこ? ― 平均値・中央値・最頻値 ―
に入ります。
まずは、品質データを手にしたときに最初に知りたくなる、
「このデータは、だいたいどのくらいなのか?」 という問いから考えていきます。
シリーズ全体の目次
『品質をデータで読み解く 統計解析・データサイエンス入門』
― 品質管理の現場で使える「見る・推定する・判断する」ための統計学 ―
全体の目次はここをご覧ください。