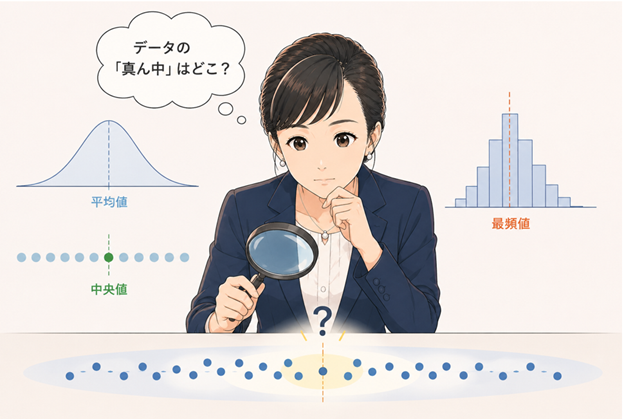
もっともよく表れる値を考える
 マナブ先生
では、ここから実際にデータを見ていきましょう。
前回は、
統計解析とは、
「データから、実際に何が起きているのかを考え、
判断するための道具」
だという話をしましたね。
 ユキさん
はい。
いきなり検定の公式を覚えるのではなくて、
まずはデータそのものを見るところから始めるんでしたね。
マナブ先生その通りです。
では最初に、
「得られたデータは、どのような特徴を持っているのか?」
を考えてみましょう。
まずは、とても簡単な例です。
次のデータを見てください。
$$ 2, 3, 5, 5, 7, 5, 2, 3 $$
この数字を見て、何か気づくことはありますか?
 ユキさん
そうですね……。
5が一番多いです。
マナブ先生そうですね。
では、このデータを誰かに一言で説明するとしたら、
「このデータでは○○という値が一番よく出ています」
と言えますね。
その○○はいくつですか?
 ユキさん
5です。
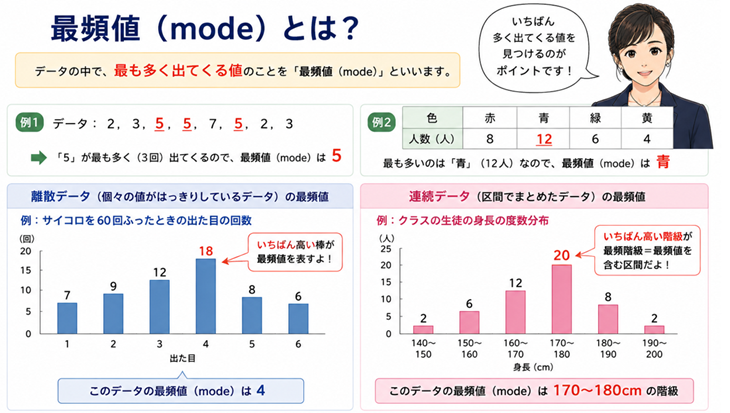
マナブ先生このように、
データの中で最も多く現れる値
を「最頻値」といいます。
英語では mode(モード) です。
データの中で、最も登場する回数が多い値
 ユキさん
一番よく出てくる値だから、「最頻値」なんですね。
名前の通りですね。
マナブ先生では、少しデータを変えてみましょう。
次のデータの最頻値は何でしょう。
$$ 1, 2, 3, 4, 5, 6, 8, 8 $$
ユキさん8だけが2回出ているので、最頻値は8です。
マナブ先生そうですね。
では、このデータを見て、
「このデータを代表する値は8です」
と言われたら、どう感じますか?
ユキさんうーん……。
ちょっと違和感があります。
8が一番多いことは確かですけど、
データ全体を見ると1から8まで広がっていますから。
「中心が8」と言われると違う気がします。
 マナブ先生
そこが大切です。
最頻値は、
「最もよく現れる値」
を表すには便利ですが、
必ずしもデータ全体の中心を表すとは限りません。
ユキさんなるほど。
「最も多い値」
と
「真ん中の値」
は違うということですね。
マナブ先生そうです。
ただし、最頻値がとても役立つデータもあります。
例えばアンケートで、
1:商品A
2:商品B
3:商品C
というように、数字を単なる記号として使っていたとしましょう。
最も多く選ばれた番号を知りたいとき、
平均を計算する意味はありますか?
ユキさんないですね。
商品Aと商品Cを平均して商品B、
というわけにはいきませんから。
マナブ先生そうですね。
このような場合は、最も回答数の多かったカテゴリー、
つまり「最頻値」に意味があります。
ユキさん選挙の多数決なども近いですね。
一番多く票を集めた候補を見るわけですから。
マナブ先生その通りです。
つまり、代表値は何でも同じように使えるわけではなく、
「どんなデータなのか」
によって意味が変わります。
真ん中にある値を考える
マナブ先生では次のデータを見てください。
今度は小さい順に並べてあります。
$$ 1, 2, 2, 3, 3, 3, 4, 4, 5 $$
このデータについて何か気づきますか?
ユキさん真ん中に3がありますね。
マナブ先生そうですね。
全部でいくつデータがありますか?
ユキさん9個です。
マナブ先生9個なら、ちょうど5番目が真ん中になります。
その値は?
ユキさん3です。
これは「中央値」ですよね。
マナブ先生よく知っていますね。
その通りです。
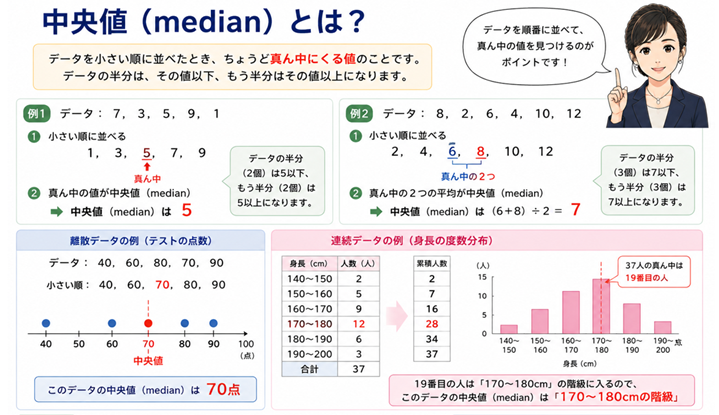
すべてのデータを小さい順、または大きい順に並べたとき、
ちょうど中央に位置する値
を「中央値」といいます。
英語では median(メディアン) です。
すべてのデータを大きさの順に並べたとき、
中央に位置する値
データの個数が偶数の場合は、
中央にある2つの値の平均を中央値とする。
 マナブ先生
例えば、
$$ 1, 2, 3, 4, 5, 6 $$
なら、中央にあるのは3と4ですね。
中央値はいくつでしょう?
ユキさん$$ (3+4)÷2=3.5 $$
なので、3.5です。
マナブ先生そうですね。
ところが、中央値にも少し面白いところがあります。
次のデータを見てください。
$$ 1, 1, 1, 3, 3 $$
中央値はいくつでしょう?
ユキさん真ん中は1なので、1です。
マナブ先生では、
$$ 1, 1, 3, 3, 3 $$
なら?
ユキさん今度は3です。
マナブ先生2つのデータを比べて、どう感じますか?
ユキさんデータそのものは、それほど大きく違っていないのに、
中央値は1から3へ一気に変わってしまいますね。
何となく、この2つのデータの「中間的な値」は
2くらいのようにも感じます。
マナブ先生いい気づきですね。
では、
「データ全体の値を使って、中心を表す」
方法は何か思い浮かびますか?
ユキさん平均でしょうか?
マナブ先生そうですね。
私たちが日常的に「平均」と呼んでいるものです。
「平均」にも種類がある
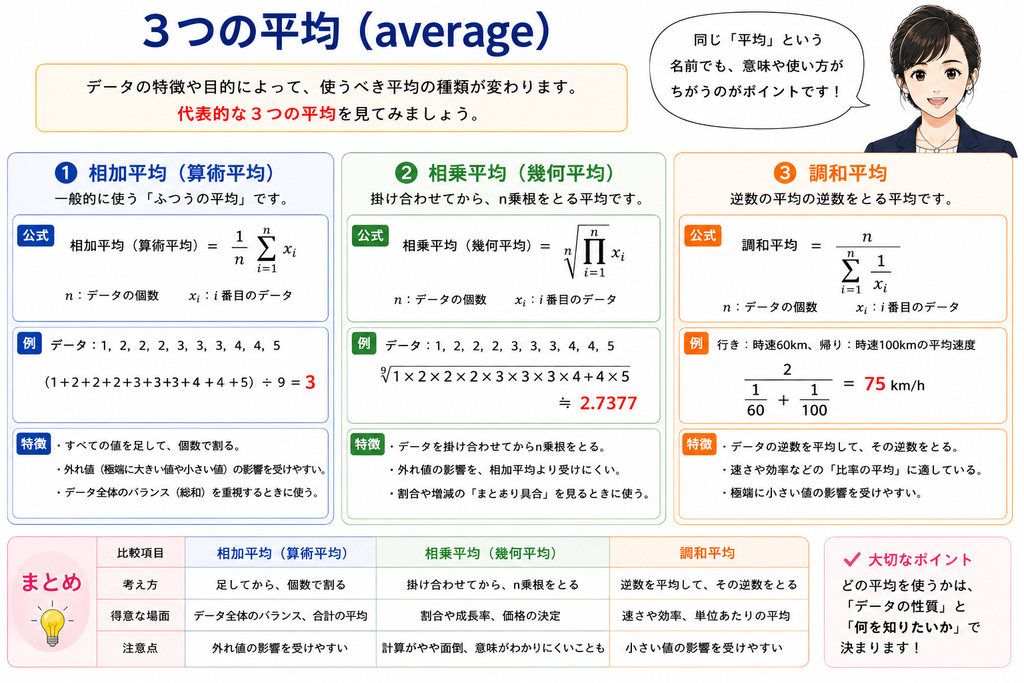
マナブ先生ただし、厳密には「平均」にもいくつか種類があります。
普段もっともよく使う平均は、「相加平均」、
あるいは「算術平均」と呼ばれます。
ユキさん相加平均?
あまり聞かない言葉ですね。
マナブ先生そうですね。
日常生活では、単に「平均」と呼ぶことがほとんどです。
計算方法は知っていますね。
ユキさん全部足して、データの個数で割る、
ですよね。
マナブ先生その通りです。
数式では、次のように表します。
\(x\)の上にある横線は”バー(bar)”と呼び、平均を意味します。
データを
\[
x_1,x_2,\dots,x_n
\]
とすると、平均値 \(\bar{x}\) は、
\[
\bar{x}=
\frac{x_1+x_2+\cdots+x_n}{n}
\]
\[
=\frac{1}{n}\sum_{i=1}^{n}x_i
\]
となる。
ユキさん\(\sum\) が出てきましたね。
マナブ先生見た目ほど難しくありません。
\(\sum\) は、
「全部足してください」
という記号です。
下にある \(i=1\) は1番目のデータから始めるという意味で、
上の \(n\) は\(n\)番目まで、という意味です。
ユキさんつまり、
\[
\sum_{i=1}^{n}x_i
\]
は、
\[
x_1+x_2+\cdots+x_n
\]
を短く書いているだけなんですね。
マナブ先生その通りです。
数式は難しいことをしているのではなく、
長い説明を短く書いている場合が多いんですよ。
平均を計算してみる
マナブ先生では、先ほどの2つのデータで平均を計算してみましょう。
まず、
$$ 1, 1, 1, 3, 3 $$
は?
ユキさん\[
\frac{1+1+1+3+3}{5}
\]
\[
=\frac{9}{5}
=1.8
\]
です。
マナブ先生では、
$$ 1, 1, 3, 3, 3 $$
は?
ユキさん\[
\frac{1+1+3+3+3}{5}
\]
\[
=\frac{11}{5}
=2.2
\]
です。
マナブ先生どう感じますか?
ユキさん中央値だと1と3でしたが、
平均だと1.8と2.2ですね。
どちらも2に近いので、
さっき感じた「真ん中は2くらい」という感覚に近いです。
マナブ先生そうですね。
平均値は、すべてのデータを使って計算するという特徴があります。
では、先ほどの
$$ 1, 2, 2, 3, 3, 3, 4, 4, 5 $$
についても平均を求めてみてください。
ユキさん\[
\frac{27}{9}
=3
\]
です。
中央値も3で、最頻値も3。
この場合は全部同じですね。
マナブ先生そうですね。
左右に比較的バランスよくデータが並んでいる場合、
平均値・中央値・最頻値が近い値になる
ことがあります。
ユキさんそうすると、やはり平均値が一番データ全体の中心を表しているのでしょうか?
平均値にも弱点がある
マナブ先生実は、そうとも言い切れないんです。
では次のデータの平均を計算してみましょう。
$$ 1, 2, 3, 4, 15 $$
ユキさん5ですね。
マナブ先生このデータを知らない人に、
「このデータの代表的な値は5です」
と説明したら、どう思いますか?
ユキさん少し変な感じがします。
5というデータ自体がありませんし、
ほとんどは1から4です。
15だけがかなり大きいですね。
マナブ先生そうですね。
では中央値は?
ユキさん3です。
マナブ先生どちらの方が、
このデータの「典型的な大きさ」
を表しているように感じますか?
ユキさんこの場合は中央値の3ですね。
マナブ先生ここが重要です。
平均値はすべてのデータを使うため、
大きな値や小さな値が一つあるだけでも影響を受けます。
このような、他のデータから大きく離れた値を
「外れ値」と呼ぶことがあります。
一方、中央値はデータの順番だけを見ますから、
極端に大きな値や小さな値の影響を比較的受けにくい
という特徴があります。
ユキさんつまり、
平均値は全部のデータを反映するけれど、
外れ値にも影響されやすい。
中央値は外れ値には強いけれど、
データの細かな値そのものはあまり反映しない。
という感じでしょうか。
マナブ先生その理解でいいですね。
年収ではなぜ「中央値」も見るのか
マナブ先生身近な例として、年収を考えてみましょう。
年収のニュースでは、
「平均年収」
と同時に、
「中央値」
が取り上げられることがあります。
なぜだと思いますか?
ユキさんすごく年収の高い人がいると、平均値が上に引っ張られるからでしょうか。
マナブ先生その通りです。
例えば、5人の年収が、
300万円、350万円、400万円、450万円、2,500万円
だったとします。
平均年収はいくらでしょう?
ユキさん$$ (300+350+400+450+2500)÷5=800 $$
なので、800万円です。
マナブ先生では、
「この5人の典型的な年収は800万円です」
と言われたら?
ユキさんかなり違和感があります。
5人中4人は450万円以下ですから。
マナブ先生中央値なら?
ユキさん400万円です。
こちらの方が、実態をイメージしやすいですね。
マナブ先生そういうことです。
だから、
平均値と中央値のどちらが正しいか
という問題ではありません。
「何を知りたいのかによって、どちらを見るべきかが変わる」
のです。
相乗平均とは?
マナブ先生ところで、先ほど「相加平均」と言いましたね。
平均という言葉がつくものは、他にもあります。
何か聞いたことがありますか?
ユキさん相乗平均でしょうか。
マナブ先生その通りです。
「相乗平均」は「幾何平均」とも呼ばれます。
\(n\) 個の正の値
\[
x_1,x_2,\dots,x_n
\]
があるとき、相乗平均 \(G\) は、
\[
G=\sqrt[n]{x_1x_2\cdots x_n}
\]
です。
ユキさん全部足すのではなくて、
全部掛けてから\(n\)乗根を取るんですね。
マナブ先生そうです。
例えば、2年間である値が、
1年目に1.2倍、
2年目に0.8倍
になったとします。
「平均すると1年間に何倍ずつ変化したと考えればよいか」
というような、倍率や成長率を平均するときに
相乗平均は意味を持ちます。
ユキさんなるほど。
単なるデータの真ん中を求めるというより、
「掛け算で変化していくもの」
を平均するときに使うんですね。
マナブ先生その理解が大切です。
品質管理の基礎的な統計解析では相加平均ほど頻繁には出てきませんが、
成長率、比率、倍率
などを扱うときには有効です。
調和平均とは?
マナブ先生もう一つ、「平均」がつく代表的なものがあります。
ユキさんうーん……思いつきません。
マナブ先生「調和平均」です。
ユキさん名前は聞いたことがあります。
マナブ先生調和平均\(H\)は以下で計算されます。
\[
H=
\frac{n}{\frac{1}{x_1}+\frac{1}{x_2}+\cdots+\frac{1}{x_n}}
=\frac{n}{\displaystyle\sum_{i=1}^{n}\frac{1}{x_i}}
\]
で表されます。
ユキさん急に難しそうになりました。
マナブ先生数式を見るより、例で考えた方が分かりやすいでしょう。
ある場所まで車で行って、同じ道を帰ってくるとします。
行きは時速60 km、帰りは時速100 kmでした。
往復の平均速度はいくらだと思いますか?
ユキさん普通に考えると、
\[
\frac{60+100}{2}=80
\]
なので、80 km/hと言いたくなります。
でも、今この問題が出てきたということは違うんですよね。
マナブ先生では、なぜ80 km/hではないのでしょう?
ユキさん……速度が遅い60 km/hのときの方が、
同じ距離を走るのに長い時間がかかるからでしょうか。
マナブ先生その通りです。
そこがポイントです。
仮に片道300 kmとして考えてみましょう。
行きは時速60 kmですから、何時間かかりますか?
ユキさん5時間です。
マナブ先生帰りは時速100 kmなら?
ユキさん3時間です。
マナブ先生往復600 kmを合計8時間で走ったことになります。
平均速度は?
ユキさん\[
600÷8=75
\]
なので、75 km/hです。
マナブ先生これを調和平均の式で計算すると、
\[
2÷(\frac{1}{60}+\frac{1}{100})=75
\]
となります。
ユキさんなるほど。
同じ距離を異なる速度で移動するような場合には、
普通の平均では駄目なんですね。
マナブ先生そういうことです。
調和平均は、
速度、効率、処理率などの「率」を平均する場面
で使われることがあります。
ただし、これから品質管理の基礎的な統計解析を学ぶうえでは、
まず相加平均をしっかり理解しておけば大丈夫です。
では、どの代表値を使えばいい?
マナブ先生ここまで、
最頻値、中央値、相加平均、相乗平均、調和平均
といろいろ出てきました。
ユキさん、少し混乱しましたか?
ユキさん最初は、
「データの真ん中なら平均を出せばいい」
と思っていました。
でも、そう単純ではないんですね。
マナブ先生では、今日の話から一番大切だと思ったことを一つ挙げるとしたら?
ユキさんそうですね……。
「どの代表値を使うかは、データの性質と、
何を知りたいかによって決まる」
ということでしょうか。
マナブ先生まさにそれです。
例えば、
最もよく現れる値を知りたい ⇒ 最頻値
データを順番に並べたときの真ん中を知りたい ⇒ 中央値
データ全体を使って中心を表したい ⇒ 相加平均
倍率や成長率の平均を考えたい ⇒ 相乗平均
速度や率を平均したい ⇒ 調和平均
というように、目的によって使い分けます。
ユキさん「平均」という一つの数字だけを見て判断してはいけない、ということですね。
平均にしても3つも種類があるのですからね。
 マナブ先生
そうですね。
品質管理でも、
「平均値が同じだから問題ありません」
と簡単に言ってしまうのは危険です。
平均値だけでは、そのデータのすべては分かりません。
ユキさんえ?
平均が分かっても、まだ足りないんですか?
マナブ先生では、次の2組のデータを見てください。
$$ A:49, 50, 50, 50, 51 $$
$$ B:30, 40, 50, 60, 70 $$
どちらも平均値はいくつでしょう?
ユキさんどちらも50ですね。
マナブ先生では、この2つのデータは同じような集団でしょうか?
ユキさん全然違います。
Aは50の近くに集まっていますが、Bはかなり広がっています。
マナブ先生そうですよね。
では、その違いを数字でどう表せばよいでしょう?
ユキさん……。
これが前回出てきた、
「ばらつき」
ですか?
マナブ先生その通りです。
代表値だけではデータの特徴を十分には説明できません。
データの中心と同時に、
「どのくらい散らばっているのか」
を見る必要があります。
次は、その「ばらつき」を数字で表す方法を考えてみましょう。
今回のポイント
データの特徴を一つの数字で表したものを代表値といいます。
代表的なものには、平均値・中央値・最頻値があります。
しかし、どれか一つが常に最も優れているわけではありません。
平均値はすべてのデータを使いますが、外れ値の影響を受けやすい。
中央値は外れ値の影響を比較的受けにくい。
最頻値は、最もよく現れる値やカテゴリーを知るのに適している。
大切なのは、
「どの数字を計算するか」ではなく、
「何を知りたいから、その数字を見るのか」
を考えることです。
これは、品質管理でもデータサイエンスでも変わりません。
あなたも考えてみましょう
ある工場で、2台の充填機AとBについて、
それぞれ5本の製品を測定したところ、
次の結果になりました。
充填機A:499, 500, 500, 500, 501 mL
充填機B:480, 490, 500, 510, 520 mL
どちらも平均充填量は500 mLです。
では、
「平均値が同じだから、2台の充填機の状態も同じ」
と言ってよいでしょうか?
この疑問が、次に学ぶ
「ばらつき」 につながっていきます。
次回
2-2.同じ平均でも品質は違う?
― ばらつきを表すレンジ・分散・標準偏差 ―
「ばらつき」は得られたデータの特性を表す非常に重要な指標です。
次回はそれについてマナブ先生とともに学んでいきます。
シリーズ全体の目次
『品質をデータで読み解く 統計解析・データサイエンス入門』
― 品質管理の現場で使える「見る・推定する・判断する」ための統計学 ―
全体の目次はここをご覧ください。