「ばらつき」とは?
 マナブ先生
前回は、データの特徴を表す値として、
平均値、中央値、最頻値について考えましたね。
ではユキさん、平均値が分かれば、
そのデータの特徴は十分に分かるでしょうか?
 ユキさん
前回の最後に出てきた例を見ると、
そうではなかったですよね。
平均値が同じでも、
データの広がり方がまったく違うことがありました。
マナブ先生そうでしたね。
では、こんな2つのデータを考えてみましょう。
$$ A:49, 50, 50, 50, 51 $$
$$ B:30, 40, 50, 60, 70 $$
どちらも平均値はいくつでしたか?
 ユキさん
どちらも50です。
マナブ先生でも、同じようなデータに見えますか?
ユキさん全然違います。
Aは50の近くにぎゅっと集まっていますが、
Bはかなり広がっています。
マナブ先生そうですね。
では、この違いを何と表現したらよさそうでしょう?
 ユキさん
データの「ばらつき」ですか?
マナブ先生その通りです。
データを見るときには、
「どこを中心にしているのか」
だけではなく、
「その中心から、どのくらい散らばっているのか」
も重要なのです。
品質管理では、このばらつきがとても大切になります。
まずは一番簡単な「ばらつき」から
マナブ先生では、前回から使っているデータをもう一度見てみましょう。
$$ 1, 2, 2, 3, 3, 3, 4, 4, 5 $$
このデータがどのくらい広がっているのかを、
一番簡単に表すとしたら、どうしますか?
ユキさん一番小さい値と
一番大きい値を
見ればよさそうですね。
マナブ先生そうですね。
最小値はいくつですか?
ユキさん1です。
マナブ先生最大値は?
ユキさん5です。
マナブ先生では、その間の幅は?
ユキさん5-1=4
ですね。
マナブ先生この
「最大値-最小値」
を「レンジ(range)」、日本語では「範囲」といいます。
\[
R=\text{最大値}-\text{最小値}
\]
データ全体がどのくらいの幅に広がっているかを表す、最も簡単な指標。
ユキさんこれは簡単ですね。
最大値と最小値さえ分かれば計算できます。
 マナブ先生
そうですね。
では、レンジが同じなら、
データのばらつき方も同じだと言えるでしょうか?
ユキさんうーん……。
例えば、
$$ 1, 3, 3, 3, 5 $$
と、
$$ 1, 1, 3, 5, 5 $$
なら、どちらも最大値5、最小値1なのでレンジは4です。
でも、真ん中のデータの並び方は違いますね。
マナブ先生そこです。
レンジは便利ですが、
計算に使っているのは何個のデータでしょう?
ユキさん最大値と最小値だけだから……
2個ですね。
マナブ先生そうです。
100個のデータがあっても、
レンジを見るだけなら使うのは両端の2個だけです。
では、データ全体のばらつきを知りたいとしたら、
どうしたくなりますか?
ユキさんできれば、全部のデータを使いたいですね。
マナブ先生そう考えるのが自然ですね。
平均値からの「距離」を考えてみる
マナブ先生では、全部のデータを使ってばらつきを考えるには、
どうしたらよいでしょう。
ヒントは、前回学んだ「平均値」です。
ユキさん平均値を中心にして、
それぞれのデータが平均値から
どれくらい離れているかを見る、
とかでしょうか?
 マナブ先生
とてもいいですね。
まさにその考え方です。
先ほどのデータ、
$$ 1, 2, 2, 3, 3, 3, 4, 4, 5 $$
の平均値はいくつでしたか?
ユキさん3です。
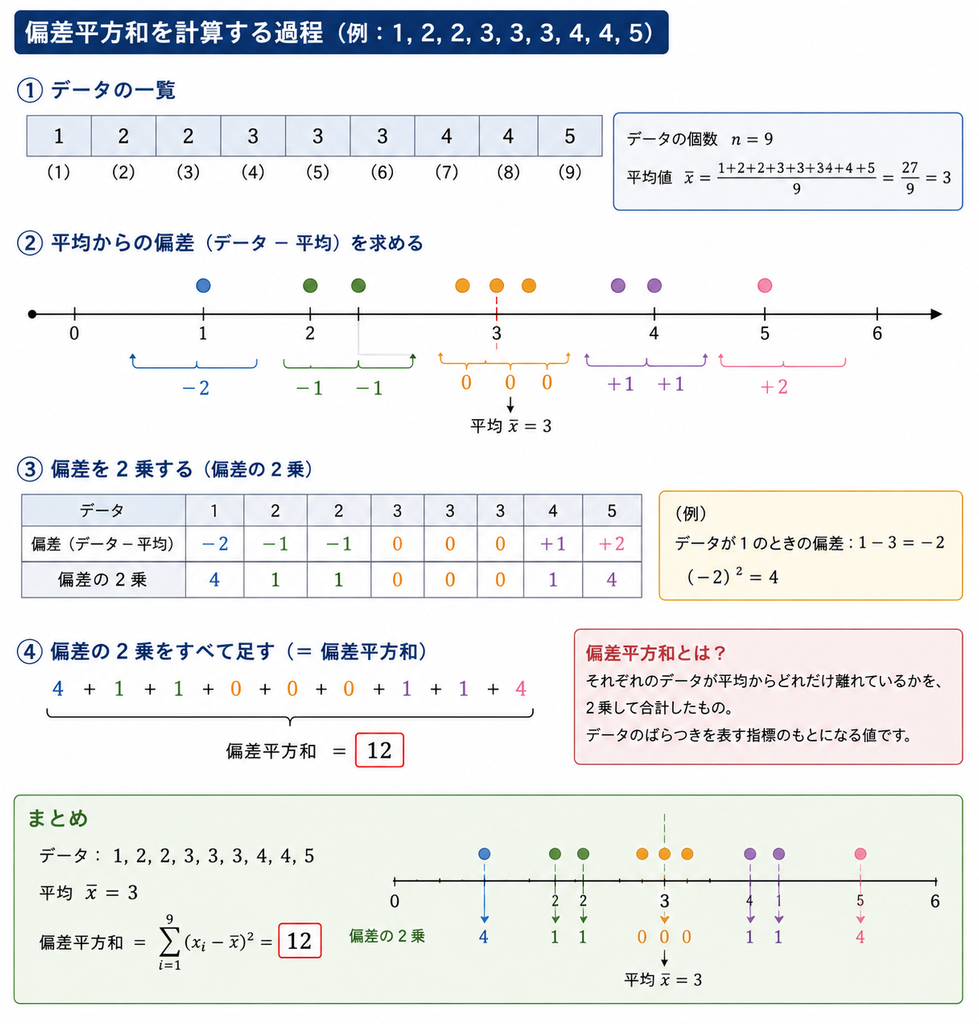
マナブ先生では、それぞれのデータから平均値3を引いてみましょう。
ユキさんはい。
1-3=-2
2-3=-1
2-3=-1
3-3=0
3-3=0
3-3=0
4-3=1
4-3=1
5-3=2
となります。
マナブ先生このような、
「各データの値-平均値」
を「偏差」といいます。
各データを \(x_i\)、平均値を \(\bar{x}\) としたとき、
\[
x_i-\bar{x}
\]
を偏差という。
マナブ先生つまり、偏差とは
「そのデータが平均値からどのくらい離れているか」
を表しています。
ユキさんなるほど。
プラスなら平均より大きく、
マイナスなら平均より小さい
ということですね。
マナブ先生そうです。
ではユキさん、この偏差を全部足せば、
「全体としてどのくらい平均から離れているか」
を表せそうではありませんか?
ユキさんそうですね。
では足してみます。
$$ -2-1-1+0+0+0+1+1+2=0 $$
なので……
あれ?
ゼロになってしまいました。
マナブ先生どうしてだと思いますか?
ユキさん平均より小さい値はマイナスで、
平均より大きい値はプラスだから、
お互いに打ち消し合ってしまうんですね。
マナブ先生その通りです。
これは偶然ではありません。
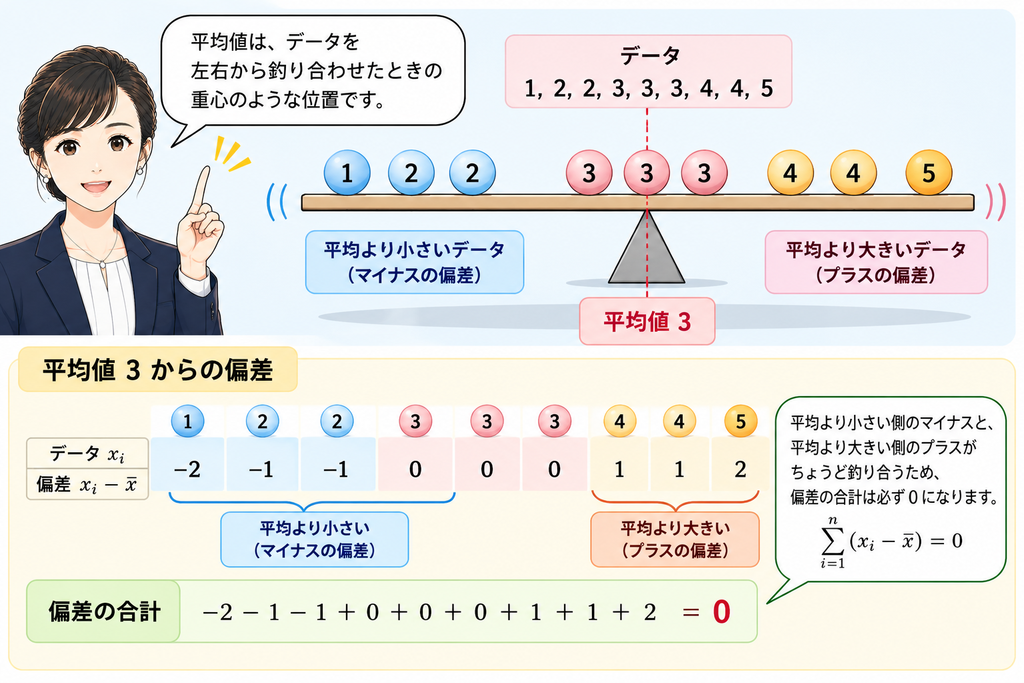
実は、平均値からの偏差をすべて足すと必ず0になります。
\[
\sum_{i=1}^{n}(x_i-\bar{x})=0
\]
ユキさん必ず0なんですか?
マナブ先生はい。
平均値は、データを左右から釣り合わせたときの
重心のような位置だと考えるとイメージしやすいでしょう。
平均より小さい側のマイナスと、
平均より大きい側のプラスが
ちょうど釣り合う場所なのです。
ユキさんなるほど。
でも、それだと偏差をそのまま足しても、
ばらつきの大きさには使えませんね。
 マナブ先生
そうなんです。
では、どうしたらよいでしょう?
マイナスを打ち消させないためには?
ユキさんマイナスをなくせばいいんですよね。
絶対値を取るとか?
マナブ先生いいですね。
実際、
\[
|x_i-\bar{x}|
\]
のように、
偏差の絶対値を利用してばらつきを表す方法もあります。
それを平均したものは、
「平均絶対偏差」などと呼ばれます。
ただ、絶対値を使う方法も立派な方法ですが、
数学的な計算や理論を展開するときに、
絶対値は少し扱いにくい性質があります。
そこで、もう一つマイナスを消す方法を考えてみましょう。
(-2) をプラスにするには、どうしたらよいでしょう?
ユキさん二乗ですね。
\[
(-2)^2=4
\]
になります。
マナブ先生そうです。
統計で二乗がよく登場する理由の一つが、
ここにあります。
偏差を二乗すれば、
\[
(-2)^2=4
\]
\[
(-1)^2=1
\]
\[
0^2=0
\]
\[
1^2=1
\]
のように、すべて0以上の値になります。
ユキさん今まで統計で二乗が出てくるたびに、
「なぜわざわざ二乗するんだろう?」
と思っていたんです。
マイナスとプラスが打ち消し合わないようにしていたんですね。
マナブ先生そう考えると、一つ意味が見えてきますね。
さらに、二乗すると平均から大きく離れたデータほど
大きな値になるという特徴もあります。
例えば偏差が1なら、
\[
1^2=1
\]
ですが、偏差が3なら、
\[
3^2=9
\]
です。
ユキさん平均から大きく離れたデータを、
より大きく評価することになるんですね。
マナブ先生その通りです。
偏差を二乗して全部足してみる
マナブ先生では、先ほどのデータの偏差を二乗して、全部足してみましょう。
ユキさん偏差は、
\[
-2,-1,-1,0,0,0,1,1,2
\]
でしたから、
\[
(-2)^2+(-1)^2+(-1)^2
+0^2+0^2+0^2
+1^2+1^2+2^2
\]
ですね。
計算すると、
\[
4+1+1+0+0+0+1+1+4=12
\]
です。
マナブ先生このように、偏差を二乗してすべて足し合わせた値を、
「偏差平方和」
あるいは単に
「平方和」
といいます。
品質管理では「変動」と呼ぶこともあります。
データ \(x_1,x_2,\dots,x_n\) の平均値を \(\bar{x}\) とすると、
\[
S=\sum_{i=1}^{n}(x_i-\bar{x})^2
\]
この値\(S\)を偏差平方和、あるいは平方和、変動と呼ぶ。
 ユキさん
今回の偏差平方和は12ですね。
でも、この12をそのままばらつきとして使ってよいのでしょうか?
マナブ先生どう思いますか?
例えば、同じ程度のばらつきのデータでも、
データ数が
10個の場合と
1,000個の場合では、
偏差平方和はどうなりそうですか?
ユキさん1,000個の方が、たくさん足すから、大きくなりそうですね。
マナブ先生そうですね。
ですから、そのままではデータ数の影響を受けてしまいます。
どうしたらよいでしょう?
ユキさんデータ数で割って、「1個当たり」にすればいいんですか?
マナブ先生その通りです。
今回のデータは9個ですから、
\[
1.333\ldots
\]
となります。
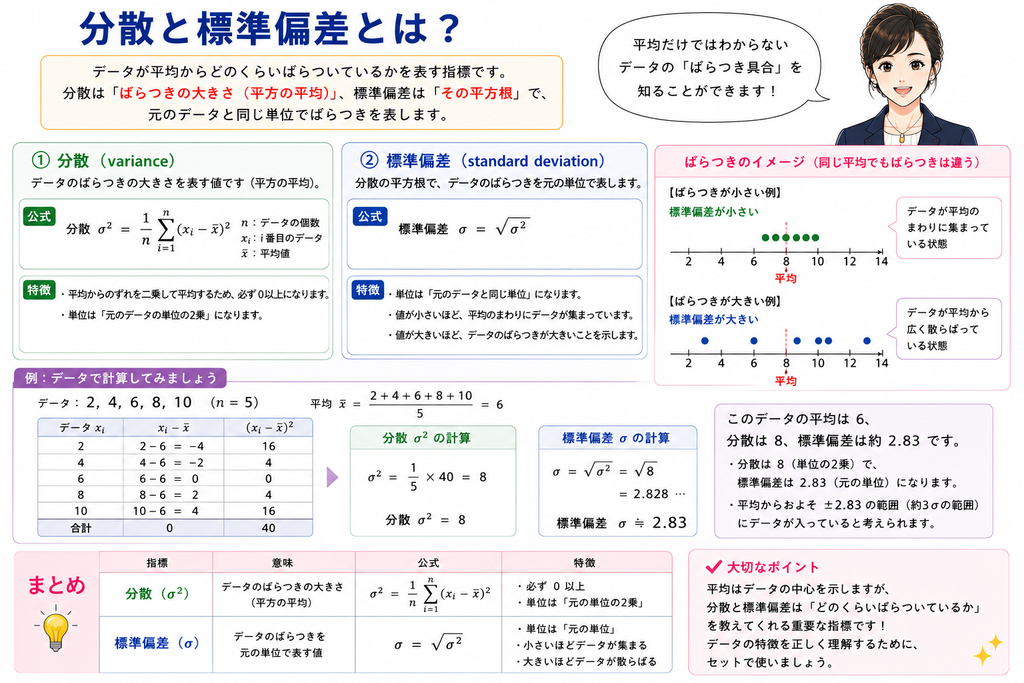
このように、偏差の二乗の平均を取ったものを「分散」といいます。
分散は\(σ^2\)で書くことが多いです。
この9個のデータそのものを一つの集団として扱う場合、分散 \(\sigma^2\) は、
\[
\sigma^2
=\frac{1}{n}
\sum_{i=1}^{n}(x_i-\bar{x})^2
\] と表される。
ユキさん偏差を求めて、それを二乗して、平均する。
それが分散なんですね。
マナブ先生そうです。
言葉で表すなら、
「データが平均のまわりに、どのくらいばらついているかを表す値」
と考えてください。
ここでは、この9個のデータ自体を一つの集団と考えているので、データ数 \(n\) で割っています。
ユキさん「ここでは」ということは、別の割り方もあるんですか?
マナブ先生鋭いですね。
あります。
後で、
「手元にある一部のデータから、
もっと大きな集団全体のばらつきを推定する」
ことを考えるようになると、
\(n\) ではなく \((n-1)\) で割る方法が出てきます。
それは不偏分散と呼ばれるものです。
ただ、今はまず、
「偏差を二乗して、その平均を取ったものが分散」
と理解しておけば十分です。
ユキさん分かりました。
今はあまり先まで考えないことにします(笑)。
でも、分散には少し困ったことがある
マナブ先生ではユキさん、
分散の式を見て、何か気になることはありませんか?
ユキさん気になること……。
あっ。
偏差を二乗していますよね。
マナブ先生はい。
ユキさん例えば、元のデータが製品の重さで、
単位がグラム \([\mathrm{g}]\)だったとします。
偏差もグラムですよね。
マナブ先生そうですね。
ユキさんそれを二乗するから、分散の単位は、
\[
\mathrm{g}^2
\]
になってしまいます。
マナブ先生その通り。
では、
「この製品のばらつきは1.33 \(\mathrm{g}^2\) です」
と言われたら、感覚的に分かりやすいでしょうか?
ユキさん全然分かりません。
重さなのに平方グラムと言われても、
実際どのくらいばらついているのか
イメージできないですね。
マナブ先生では、元のグラムという単位に戻すにはどうしたらよいでしょう?
ユキさん二乗したのだから……平方根を取ればいい?
マナブ先生その通りです。
分散の平方根を取ったものを、
「標準偏差」といいます。
分散 \(\sigma^2\) の平方根を、
標準偏差 \(\sigma\)という。
\[
\sigma
=\sqrt{\sigma^2}
=\sqrt{
\frac{1}{n}
\sum_{i=1}^{n}(x_i-\mu)^2
}
\]
ユキさんなるほど。
だから
分散を \(\sigma^2\) と書いて、
標準偏差を \(\sigma\) と書くんですね。
マナブ先生そうです。
では今回のデータ、
$$ 1, 2, 2, 3, 3, 3, 4, 4, 5 $$
の標準偏差を求めてみましょう。
ユキさん分散が、
\(1.333\ldots\)
ですから、
\[
\sqrt{\frac{12}{9}}
\]
なので、
\[
\sigma
\approx1.15
\]
ですね。
マナブ先生そうです。
このデータは
平均値が3、
標準偏差がおよそ1.15
ということになります。
ユキさん平均値がデータの中心を表して、
標準偏差が、その中心からどのくらい広がっているかを表している。
そういう組み合わせで見るんですね。
マナブ先生まさにそこが重要です。
平均値だけを見ても、データの姿は十分には分かりません。
例えば、
平均値50、標準偏差1
の工程と、
平均値50、標準偏差10
の工程では、品質管理上の意味はまったく違います。
ユキさん平均は同じでも、
後者は製品の値がかなりばらついている可能性がある
ということですね。
マナブ先生そうです。
品質管理では、
「狙った値になっているか」
だけでなく、
「安定してその値を作れているか」
を見ることがとても重要なのです。
レンジ・分散・標準偏差を整理すると
マナブ先生ではユキさん、今日出てきた3つを整理してみましょう。
まず「レンジ」とは?
ユキさん最大値と最小値の差です。
\[
R=\text{最大値}-\text{最小値}
\]
ですね。
簡単に計算できるけれど、最大値と最小値しか使わない。
マナブ先生そうですね。
では「分散」は?
ユキさんそれぞれのデータについて平均値からの差、
つまり偏差を求めて、それを二乗して平均したものです。
データ全体のばらつきを表すことができます。
マナブ先生「標準偏差」は?
ユキさん分散の平方根です。
分散は単位まで二乗されてしまいますが、
標準偏差なら元のデータと同じ単位になるので、
ばらつきの大きさをイメージしやすくなります。
マナブ先生いいですね。
もう一つ質問です。
なぜ偏差をそのまま平均しないのでしょう?
ユキさん平均値より小さいデータはマイナス、
大きいデータはプラスになるので、
すべて足すと0になってしまうからです。
マナブ先生では、なぜ二乗するのでしょう?
ユキさんプラスとマイナスが打ち消し合わないようにするため。
それから、平均値から大きく離れた値をより大きく評価するためですね。
マナブ先生十分です。
もう公式をただ暗記する必要はなさそうですね。
ユキさんはい。
今までは、
「標準偏差はこの公式だから覚える」
という感じだったんです。
でも、
平均からの距離を考える
↓
そのまま足すと0になる
↓
だから二乗する
↓
二乗した偏差を平均する
↓
それが分散
↓
元の単位に戻すため平方根を取る
↓
それが標準偏差
と考えると、ずっと分かりやすいですね。
マナブ先生その理解ができれば十分です。
統計の公式は、理由もなく作られているわけではありません。
「何を知りたいのか」
から順番に考えると、式の形にも意味が見えてきます。
データの特徴をつかむのまとめ
マナブ先生それではこれまで出てきた代表的な値を
もう少し具体的な数字で見てみましょう。
何がいい例がありますか?
ユキさん統計の教科書ではテストの点数の例が出てきますけど。
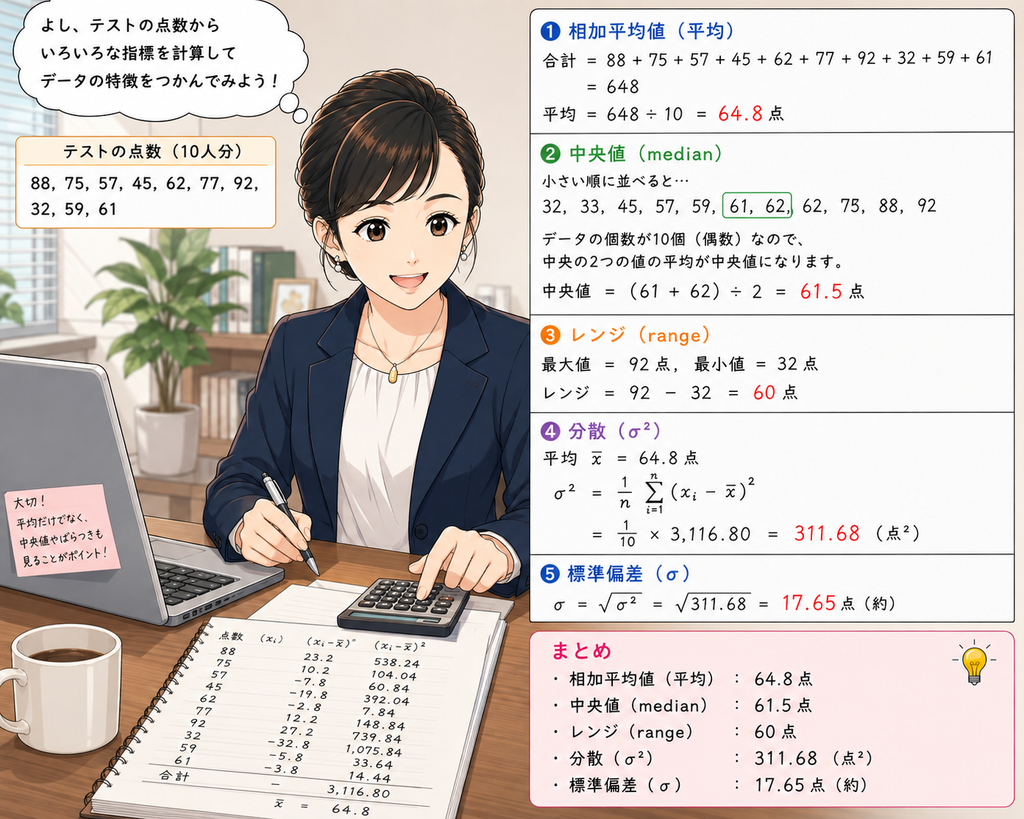
マナブ先生それではテストの点数について考えましょう。
思いつく数字を10個あげてみてください。
ユキさん88点、75点、57点、45点、62点、77点、92点、32点、59点、61点
はどうでしょうか?
マナブ先生いいですね。
それらの平均値、中央値、レンジ、分散、標準偏差を求めてください。
まずどのような操作をするといいと思いますか?
ユキさん中央値を求めるのであれば、大きさの順に並べた方がいいですね。
そして、平均を求めるには全部の和を求めるので…、
マナブ先生、Excelを使ってもいいですか?
マナブ先生この後で、Excelの使い方を教えますが、
まずは電卓を使って手計算で求めてみましょう。
ユキさん大変ですね。でも頑張ってみます。
マナブ先生一度はすべてを手で計算することを経験した方が身に付きます。
表の形にするといいですよ。
ユキさんこのような感じですか?
| 番号 | データ | 偏差 | 偏差平方 |
|---|---|---|---|
| 1 | 32 | 32-64.8=-32.8 | (-32.8)2=1075.84 |
| 2 | 45 | 45-64.8=-19.8 | (-19.8)2=392.04 |
| 3 | 57 | 57-64.8=-7.8 | (-7.8)2=60.84 |
| 4 | 59 | 59-64.8=-5.8 | (-5.8)2=33.64 |
| 5 | 61 | 61-64.8=-3.8 | (-3.8)2=14.44 |
| 6 | 62 | 62-64.8=-2.8 | (-2.8)2=7.84 |
| 7 | 75 | 75-64.8=10.2 | 10.22=104.04 |
| 8 | 77 | 77-64.8=12.2 | 12.22=148.84 |
| 9 | 88 | 88-64.8=23.2 | 23.22=538.24 |
| 10 | 92 | 92-64.8=27.2 | 27.22=739.84 |
| 合計 | 648 | 3115.6 |
ユキさん$$ レンジ=92-32=60 $$
$$ 中央値 = (61+62)÷2 = 61.5 $$
$$ 平均値 = 648÷10 = 64.8 $$
$$ 分散 = 3115.6÷10 = 311.56 $$
$$ 標準偏差 = \sqrt{311.56} ≒ 17.65 $$
となりました。
マナブ先生よくできました。
データの特徴をつかむためのExcel関数
マナブ先生それではExcelの関数の使い方を見ていきましょう。
ユキさん実際のデータ数はもっと多くなり、
日々管理することになるので、
Excelの関数を教えてもらえればうれしいです。
マナブ先生以下が代表的なExcelの関数です。
| 内容 | 関数名 |
|---|---|
| 最大値 | MAX(範囲) |
| 最小値 | MIN(範囲) |
| 中央値 | MEDIAN(範囲) |
| 最頻値 | MODE.SNGL(範囲) |
| 平均値(相加平均) | AVERAGE(範囲) |
| 相乗平均(幾何平均) | GEOMEAN(範囲) |
| 調和平均 | HARMEAN(範囲) |
| 偏差平方和 | DEVSQ(範囲) |
| 分散 | VAR.P(範囲) |
| 標準偏差 | STDEV.P(範囲) |
マナブ先生直接レンジを求める関数はありませんが、
レンジを求めるにはどうすればいいと思いますか?
ユキさん最大値から最小値を引けばいいので、
MAX(範囲)-MIN(範囲)で計算できます。
マナブ先生正解です。
今回のポイント
データの特徴を見るとき、平均値などの「中心」だけでは十分ではありません。
もう一つ重要なのが、
「データがどのくらいばらついているか」
です。
最も簡単なばらつきの指標がレンジ(範囲)です。
\(
R=\text{最大値}-\text{最小値}
\)
ただし、レンジは最大値と最小値しか使いません。
そこで、すべてのデータを使ってばらつきを表すため、
平均値からの差=偏差
を考えます。
しかし、偏差はそのまま足すとプラスとマイナスが打ち消し合って0になります。
そこで偏差を二乗し、その平均を求めたものが分散です。
さらに、分散の平方根を取ったものが標準偏差です。
つまり、
平均値 → データの中心
標準偏差 → データのばらつき
を表します。 品質管理では、この2つをセットで見ることがとても重要です。
あなたも考えてみましょう
2台の充填機A、Bから、それぞれ5本の製品を測定しました。
$$ 充填機A:499, 500, 500, 500, 501 mL $$
$$ 充填機B:480, 490, 500, 510, 520 mL $$
どちらも平均充填量は、
$$ 500 mL $$
です。
しかし、品質管理担当者として見たとき、
「平均値が同じだから、2台とも同じように管理できている」
と言えるでしょうか?
平均値だけでなく、
「値がどのように分布しているのか」 を見ることで、データの姿がさらに見えてきます。
次回
2-3.数字の列を「形」にして見る
― ヒストグラムからデータの全体像をつかむ ―
得られているデータの全体像をグラフ化してみることができるヒストグラムについて学びます。
シリーズ全体の目次
『品質をデータで読み解く 統計解析・データサイエンス入門』
― 品質管理の現場で使える「見る・推定する・判断する」ための統計学 ―
全体の目次はここをご覧ください。